Les progrès de l’IA face aux experts humains : intelligence fluide, connaissances et raisonnements scientifiques, capacités agentiques
Septembre 2026|Auteur(s) : GPAI Policy Lab
Une question qui anime nos travaux est d’anticiper la date à laquelle les modèles d’IA à usage général pourraient devenir meilleurs que les experts humains sur toutes les tâches cognitives. Le profil de compétences de ces IA étant très hétérogène, nous cherchons en particulier à estimer quand ces modèles rattraperont les experts humains dans les domaines où ils sont actuellement le plus en retard.
Dans un billet précédent, nous avions ajouté des références de performance humaine à l’Epoch Capabilities Index (ECI), une échelle agrégeant les scores de nombreux benchmarks en un score unique par modèle d’IA. L’objectif était de comparer les capacités des IA à des niveaux d’expertise humaine afin d’anticiper leur potentiel dépassement.
Une difficulté persistait :
- la plupart des humains obtiennent des scores quasi parfaits sur certains benchmarks de raisonnement abstrait comme ARC-AGI ou VPCT, mais des scores proches du hasard sur les benchmarks de connaissances scientifiques, type GPQA ;
- les IA de frontière montrent le profil exactement inverse sur ces mêmes benchmarks.
Cette incohérence implique qu’il n’est pas possible de produire ces deux classements à la fois avec un indice unique de capacité. Ce billet lève cette limite en passant à un modèle mathématique à quatre axes de compétence, dans un cadre bayésien permettant une meilleure estimation des incertitudes.
En bref
Nous avons étendu l’Epoch Capabilities Index à quatre axes de compétence, dans un cadre bayésien où chaque capacité estimée est accompagnée de son incertitude et où les niveaux humains sont intégrés au modèle mathématique comme des sujets évalués à part entière.
Résultats principaux :
- Les quatre axes qui émergent sont Intelligence Fluide, Connaissances et Raisonnement Scientifiques, Capacités Agentiques et Questions-Réponses (obsolète).
- Les modèles d’IA ont désormais dépassé tous les niveaux humains sur l’axe Connaissances et Raisonnement Scientifiques. Ce résultat reflète principalement l’étendue de leurs connaissances, et secondairement leurs compétences de recherche.
- Sur les Capacités Agentiques, la frontière atteint actuellement le niveau du Généraliste Qualifié (été 2026).
- Sur l’Intelligence Fluide, les IA ont probablement dépassé l’Humain Moyen, mais les experts humains gardent pour l’instant l’avantage. Si la tendance se poursuit, elle croisera les niveaux humains les plus élevés en 2027 et 2028.
Points méthodologiques :
- Les données sont éparses, les IA et humains n’étant évalués en moyenne que sur 6 % des benchmarks. Le modèle mathématique ne converge donc pas vers une réponse unique par lui-même, ce que nous avons résolu en ajoutant deux éléments a priori : un ordre strict sur les niveaux humains et une attente souple de progression le long des versions successives d’une même famille de modèles d’IA (GPT, Claude Opus).
- Quatre des dix chaînes d’échantillonnage convergent vers un second mode, qui place les niveaux humains un peu différemment et déplace les dates des projections de quelques mois à quelques années, sans altérer les conclusions.
Le point de départ, un indice unidimensionnel
Nous partons de la version bayésienne de l’ECI proposée par Alexander Barry, que nous avons reconstruite en Python avec PyMC. Dans ce cadre bayésien, au lieu d’obtenir une seule valeur pour chaque paramètre, on échantillonne des distributions de valeurs plausibles, ce qui permet de quantifier l’incertitude autour de chaque capacité estimée.
Nous intégrons aussi les neuf niveaux humains de référence (human baselines) comme des sujets évalués aux côtés des systèmes d’IA, de l’Humain Moyen jusqu’aux Comités d’Experts du Domaine, en passant par deux niveaux lycéens. Les références et la table des benchmarks ont été mises à jour et étendues depuis le billet précédent (les tables complètes, avec leurs sources, sont en annexe), et un a priori d’ordre partiel a été ajouté sur les niveaux humains (voir sections suivantes). Pour cette échelle unidimensionnelle uniquement, nous avons exclu les benchmarks faciles pour les humains comme ARC-AGI ou VPCT, comme dans le billet précédent (la liste est en annexe).
Nous appelons l’indice reconstruit ECI-H (H pour les références humaines). Nos valeurs diffèrent de celles publiées par Epoch AI pour trois raisons principales. D’abord, notre ensemble de benchmarks est plus large et écarte huit benchmarks faciles pour les humains (pour cette échelle unidimensionnelle uniquement). Ensuite, Epoch AI publie une valeur par modèle d’IA, en retenant son meilleur score sur chaque benchmark, alors que nous traitons chaque variante d’effort de raisonnement comme un sujet à part entière, avec ses propres scores. Enfin, nous incluons des références humaines dans l’analyse.
Chaque benchmark se voit également attribuer un niveau de difficulté sur la même échelle, ce qui permet de représenter ensemble, dans le temps, les systèmes d’IA, les benchmarks et les niveaux humains.
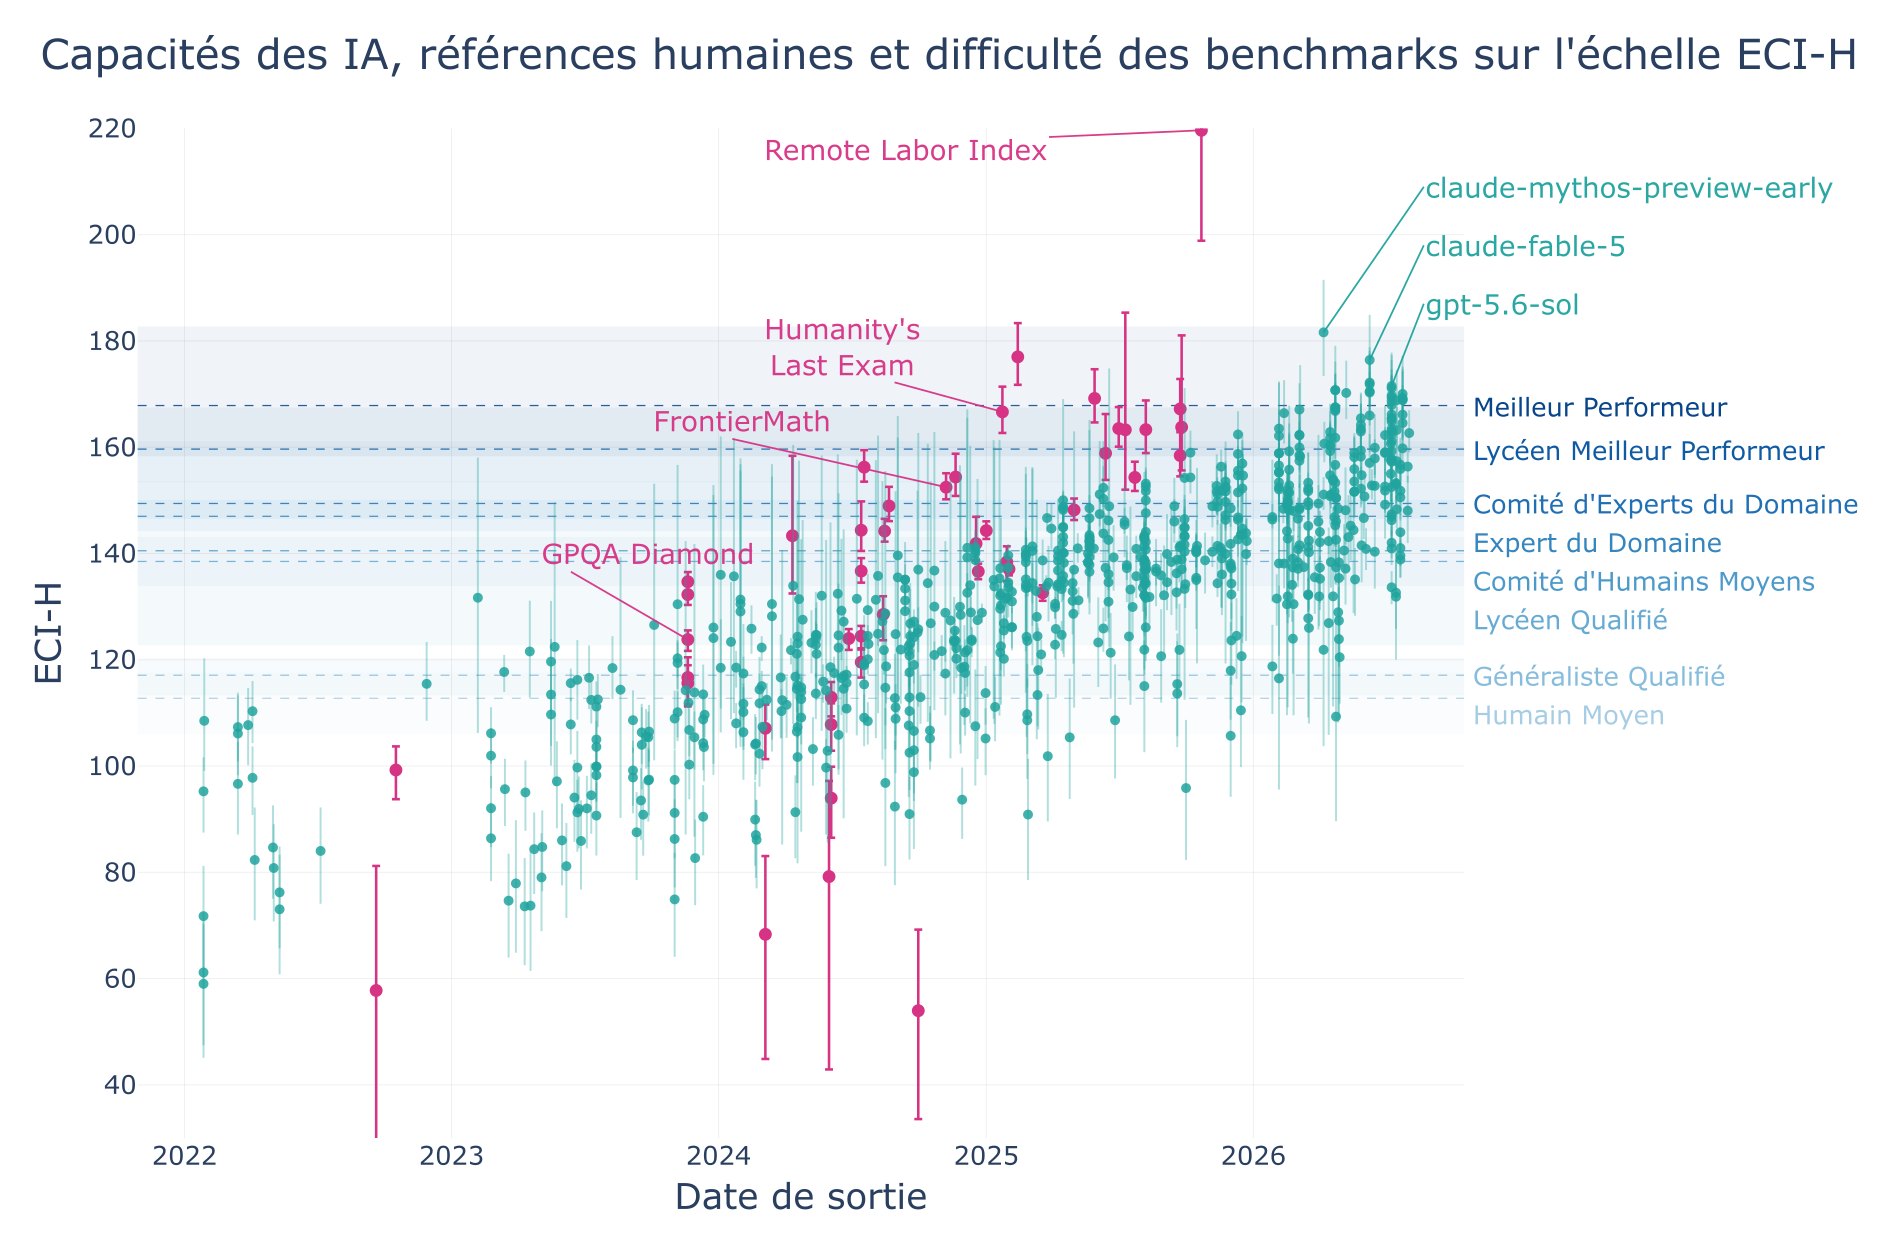
Toutefois, placer les IA et les humains sur un axe de compétence unique reste très discutable.
L’extension multidimensionnelle
Comme évoqué plus haut et discuté dans le billet précédent, certains benchmarks sont triviaux pour les humains et difficiles pour les IA, ce qui brise l’hypothèse d’un axe de capacité unique. L’analyse d’Epoch AI « Benchmark Scores = General Capability + Claudiness » pointe elle aussi vers des scores portés par plus d’une dimension, et cela sans même que les références humaines ne soient incluses. Nous testons donc cette hypothèse en étendant l’échelle à quatre axes de compétence à l’aide d’un modèle mathématique dit MIRT (Multidimensional Item Response Theory), un outil classique de la psychométrie, tout en conservant l’ensemble des benchmarks et les références humaines.
L’intuition est la suivante : chaque sujet possède quatre capacités qui forment son profil de compétence, comme un élève peut être fort en algèbre et faible en rédaction, et chaque benchmark pondère les compétences sur lesquelles il repose. Comme les données seules ne suffisent pas à identifier le modèle mathématique que nous avons construit, deux hypothèses d’ordre sont introduites. Nous ajoutons d’une part un ordre strict sur les niveaux humains et de l’autre une attente d’amélioration le long des versions d’une même famille de modèles d’IA (GPT, Claude Opus). La description détaillée de l’approche de modélisation et de ses hypothèses est donnée dans la section Méthodologie.
Résultats
Avec ces hypothèses en place, le modèle mathématique se fixe sur une réponse unique pour les axes de capacité sur toutes les chaînes d’échantillonnage. Voyons les résultats qui en découlent.
Les axes
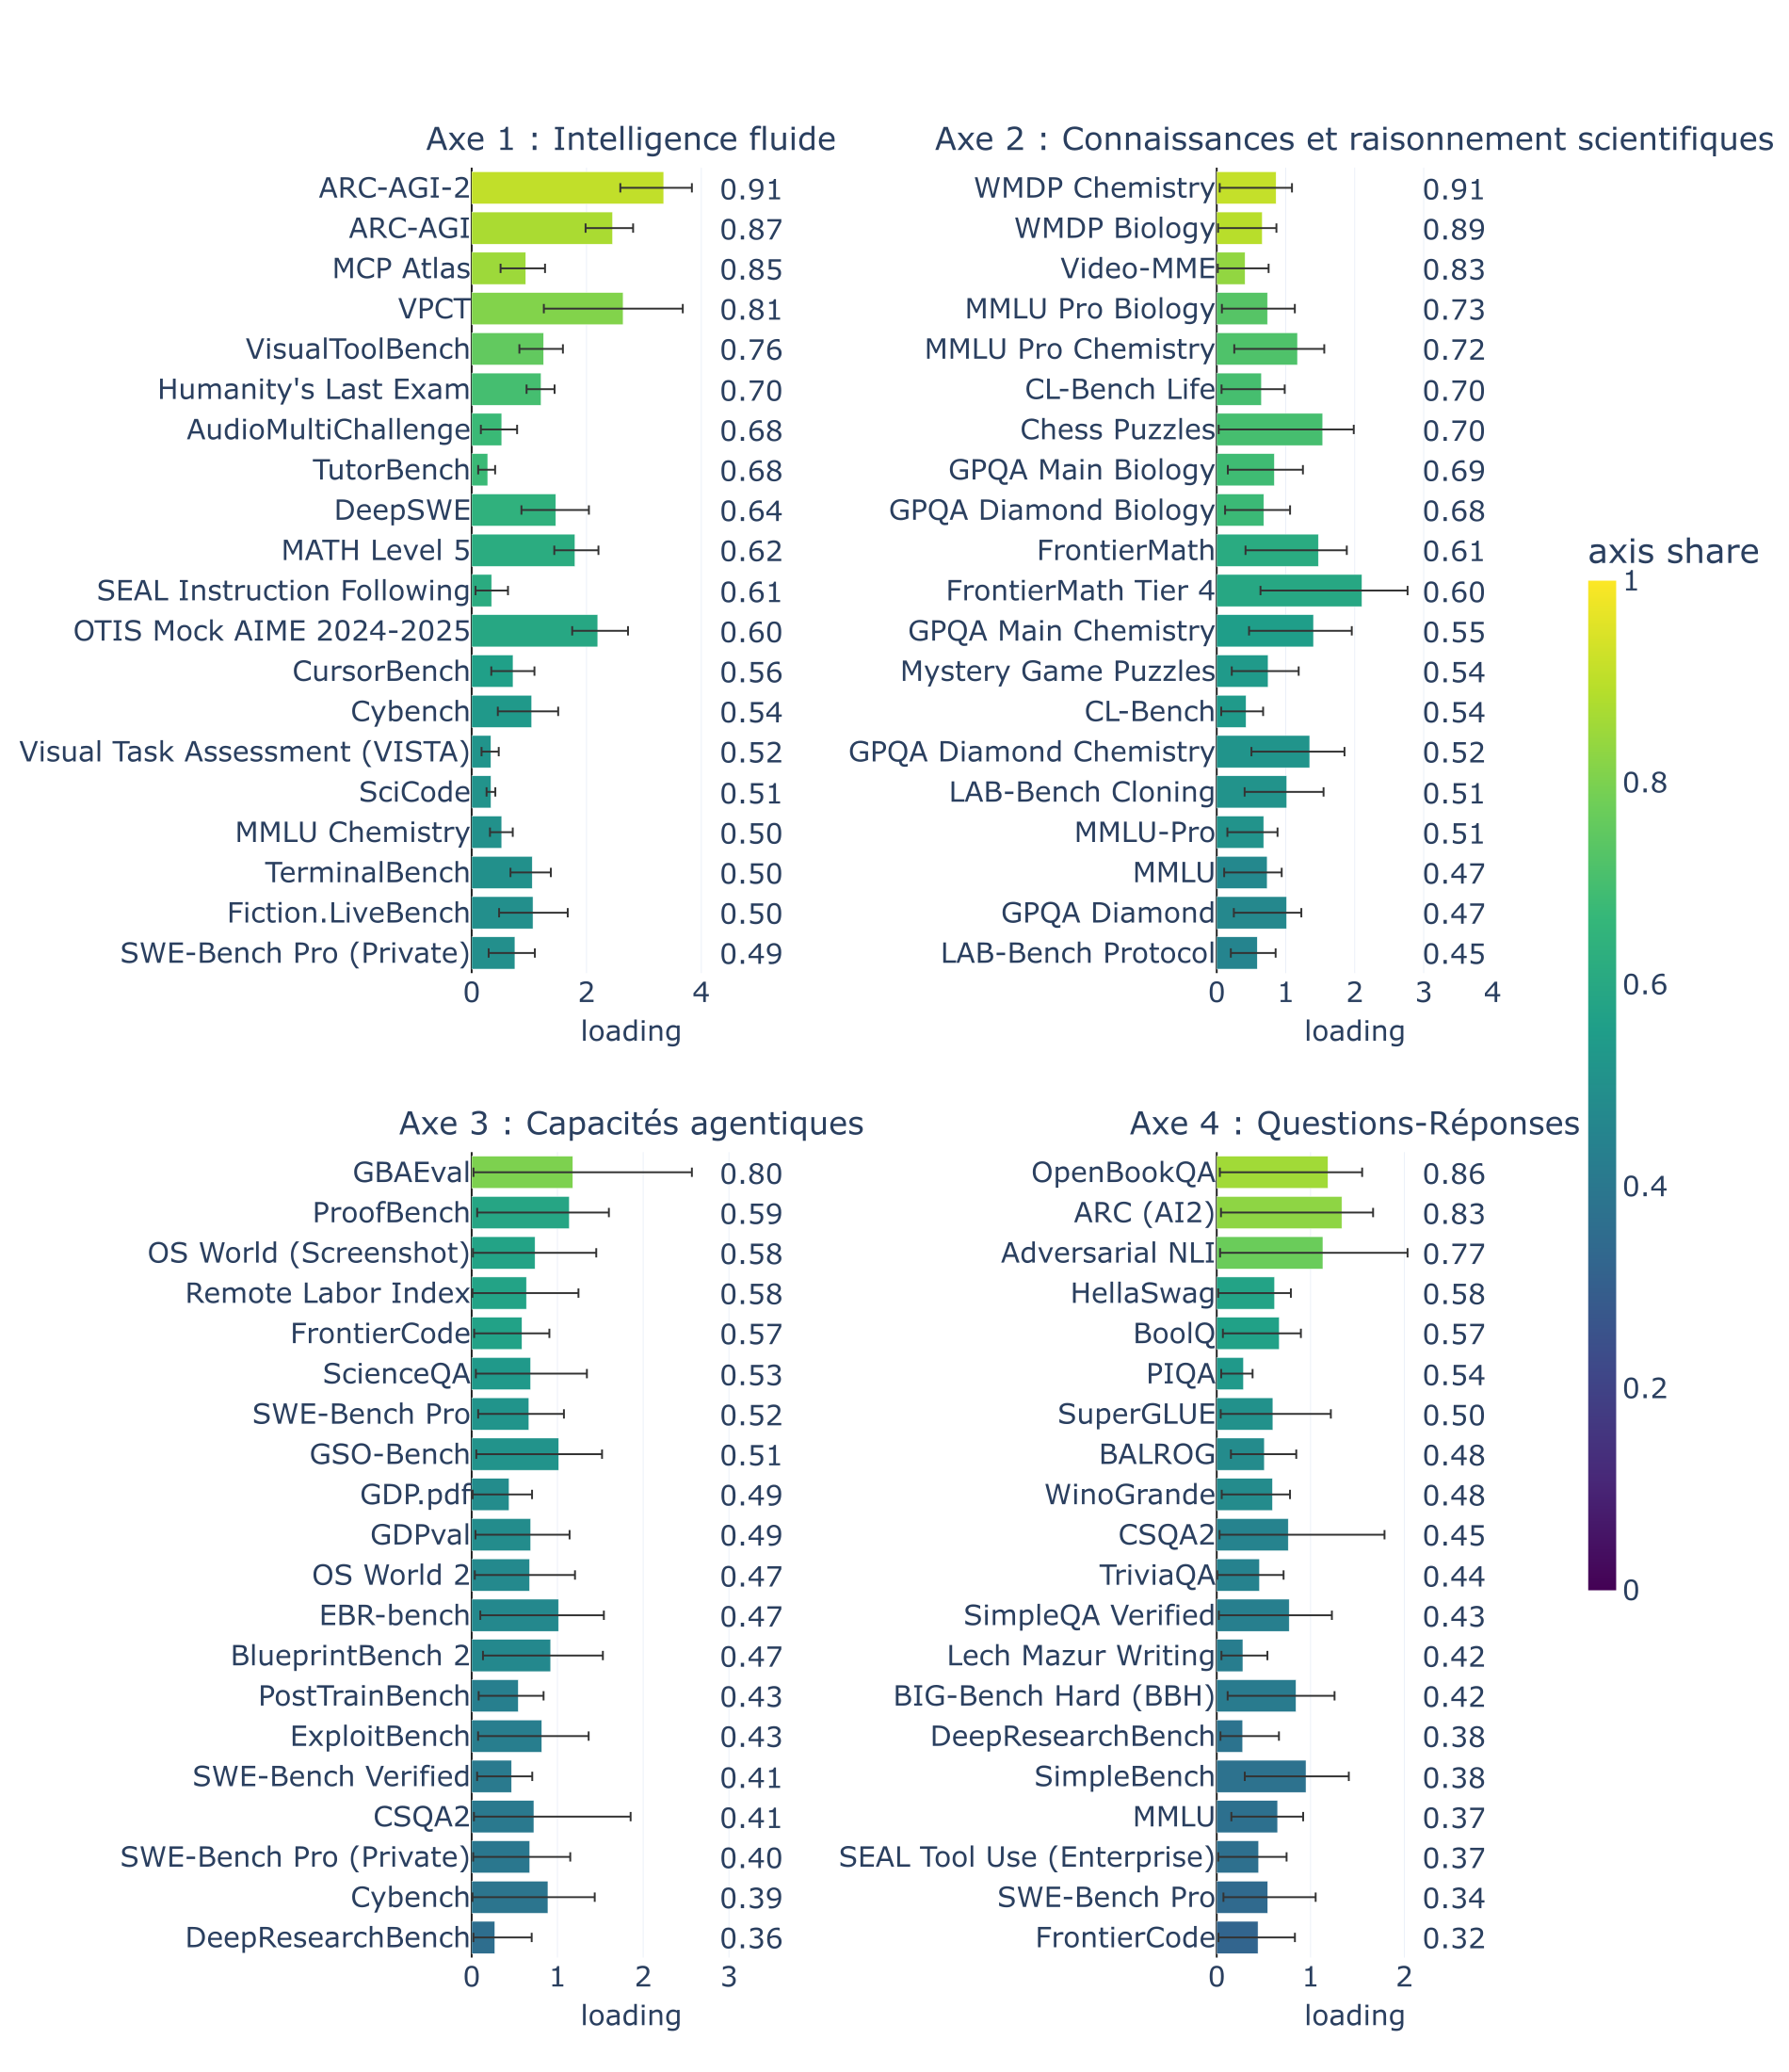
Nous nommons chaque axe d’après les benchmarks dont les vecteurs de pondérations lui sont les plus colinéaires, c’est-à-dire les benchmarks qui sollicitent cette compétence et presque rien d’autre.
- Axe 1 : Intelligence Fluide, défini par ARC-AGI-2, ARC-AGI et VPCT, des benchmarks de puzzles abstraits.
- Axe 2 : Connaissances et Raisonnement Scientifiques, défini par WMDP Chimie et Biologie, les sous-ensembles scientifiques de GPQA et FrontierMath.
- Axe 3 : Capacités Agentiques, défini par GBAEval, le Remote Labor Index et SWE-Bench Pro, des benchmarks où les modèles d’IA mènent des tâches longues plutôt que de répondre à des questions.
- Axe 4 : Questions-Réponses (obsolète), composé pour l’essentiel d’anciens benchmarks de questions-réponses largement saturés : OpenBookQA, ARC (AI2), BoolQ et similaires.
Voici comment les meilleurs modèles d’IA se comparent aux humains sur chaque axe.
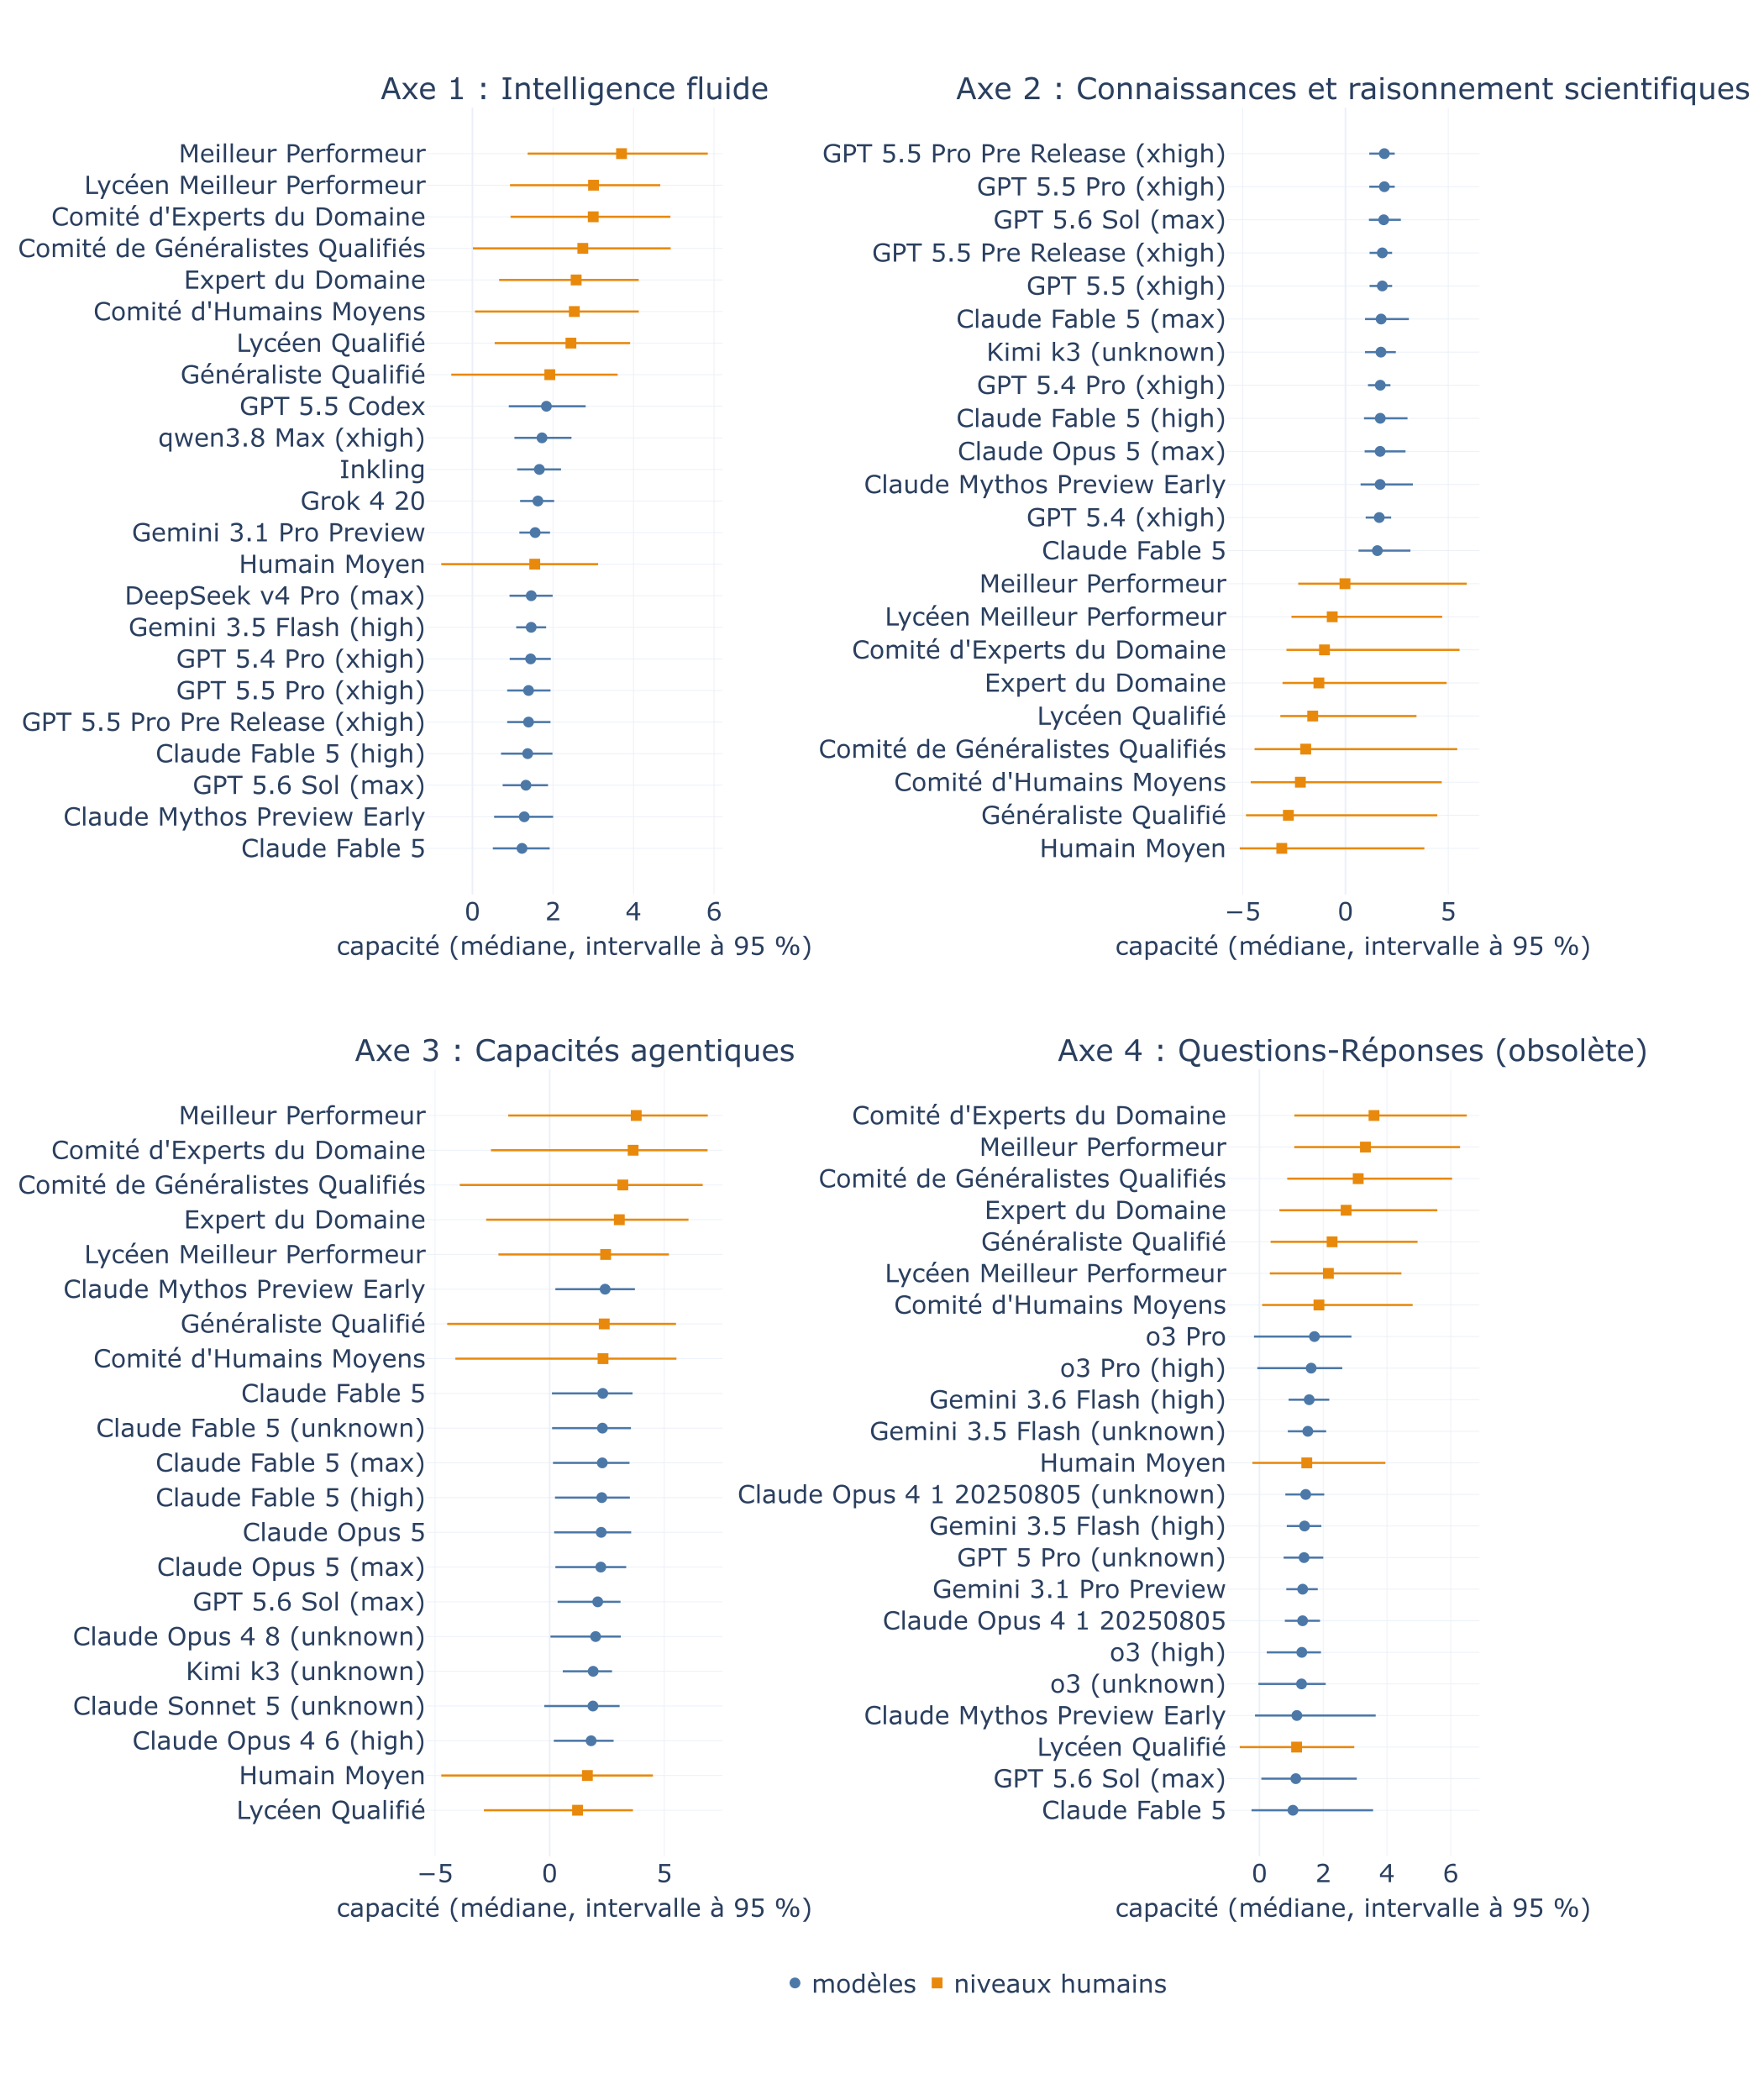
Les IA de frontière dépassent tous les niveaux humains sur les Connaissances et Raisonnement Scientifiques. Sur l’Intelligence Fluide, c’est l’inverse. Chaque niveau humain, à l’exception de l’Humain Moyen, se place au-dessus des meilleurs systèmes d’IA. Sur les Questions-Réponses (obsolète), les humains dominent également, mais il s’agit plutôt d’un artefact de données. Les huit benchmarks qui définissent cet axe le plus purement (part d’axe supérieure à un demi) n’ont plus été passés par des modèles d’IA depuis mi-2024, la plupart y plafonnant déjà autour de 0,9, et aucun modèle d’IA de frontière n’y a jamais été mesuré. L’avance humaine sur cet axe est donc une comparaison avec un bassin figé de modèles d’IA anciens, jamais confrontée à la frontière actuelle.
Projections
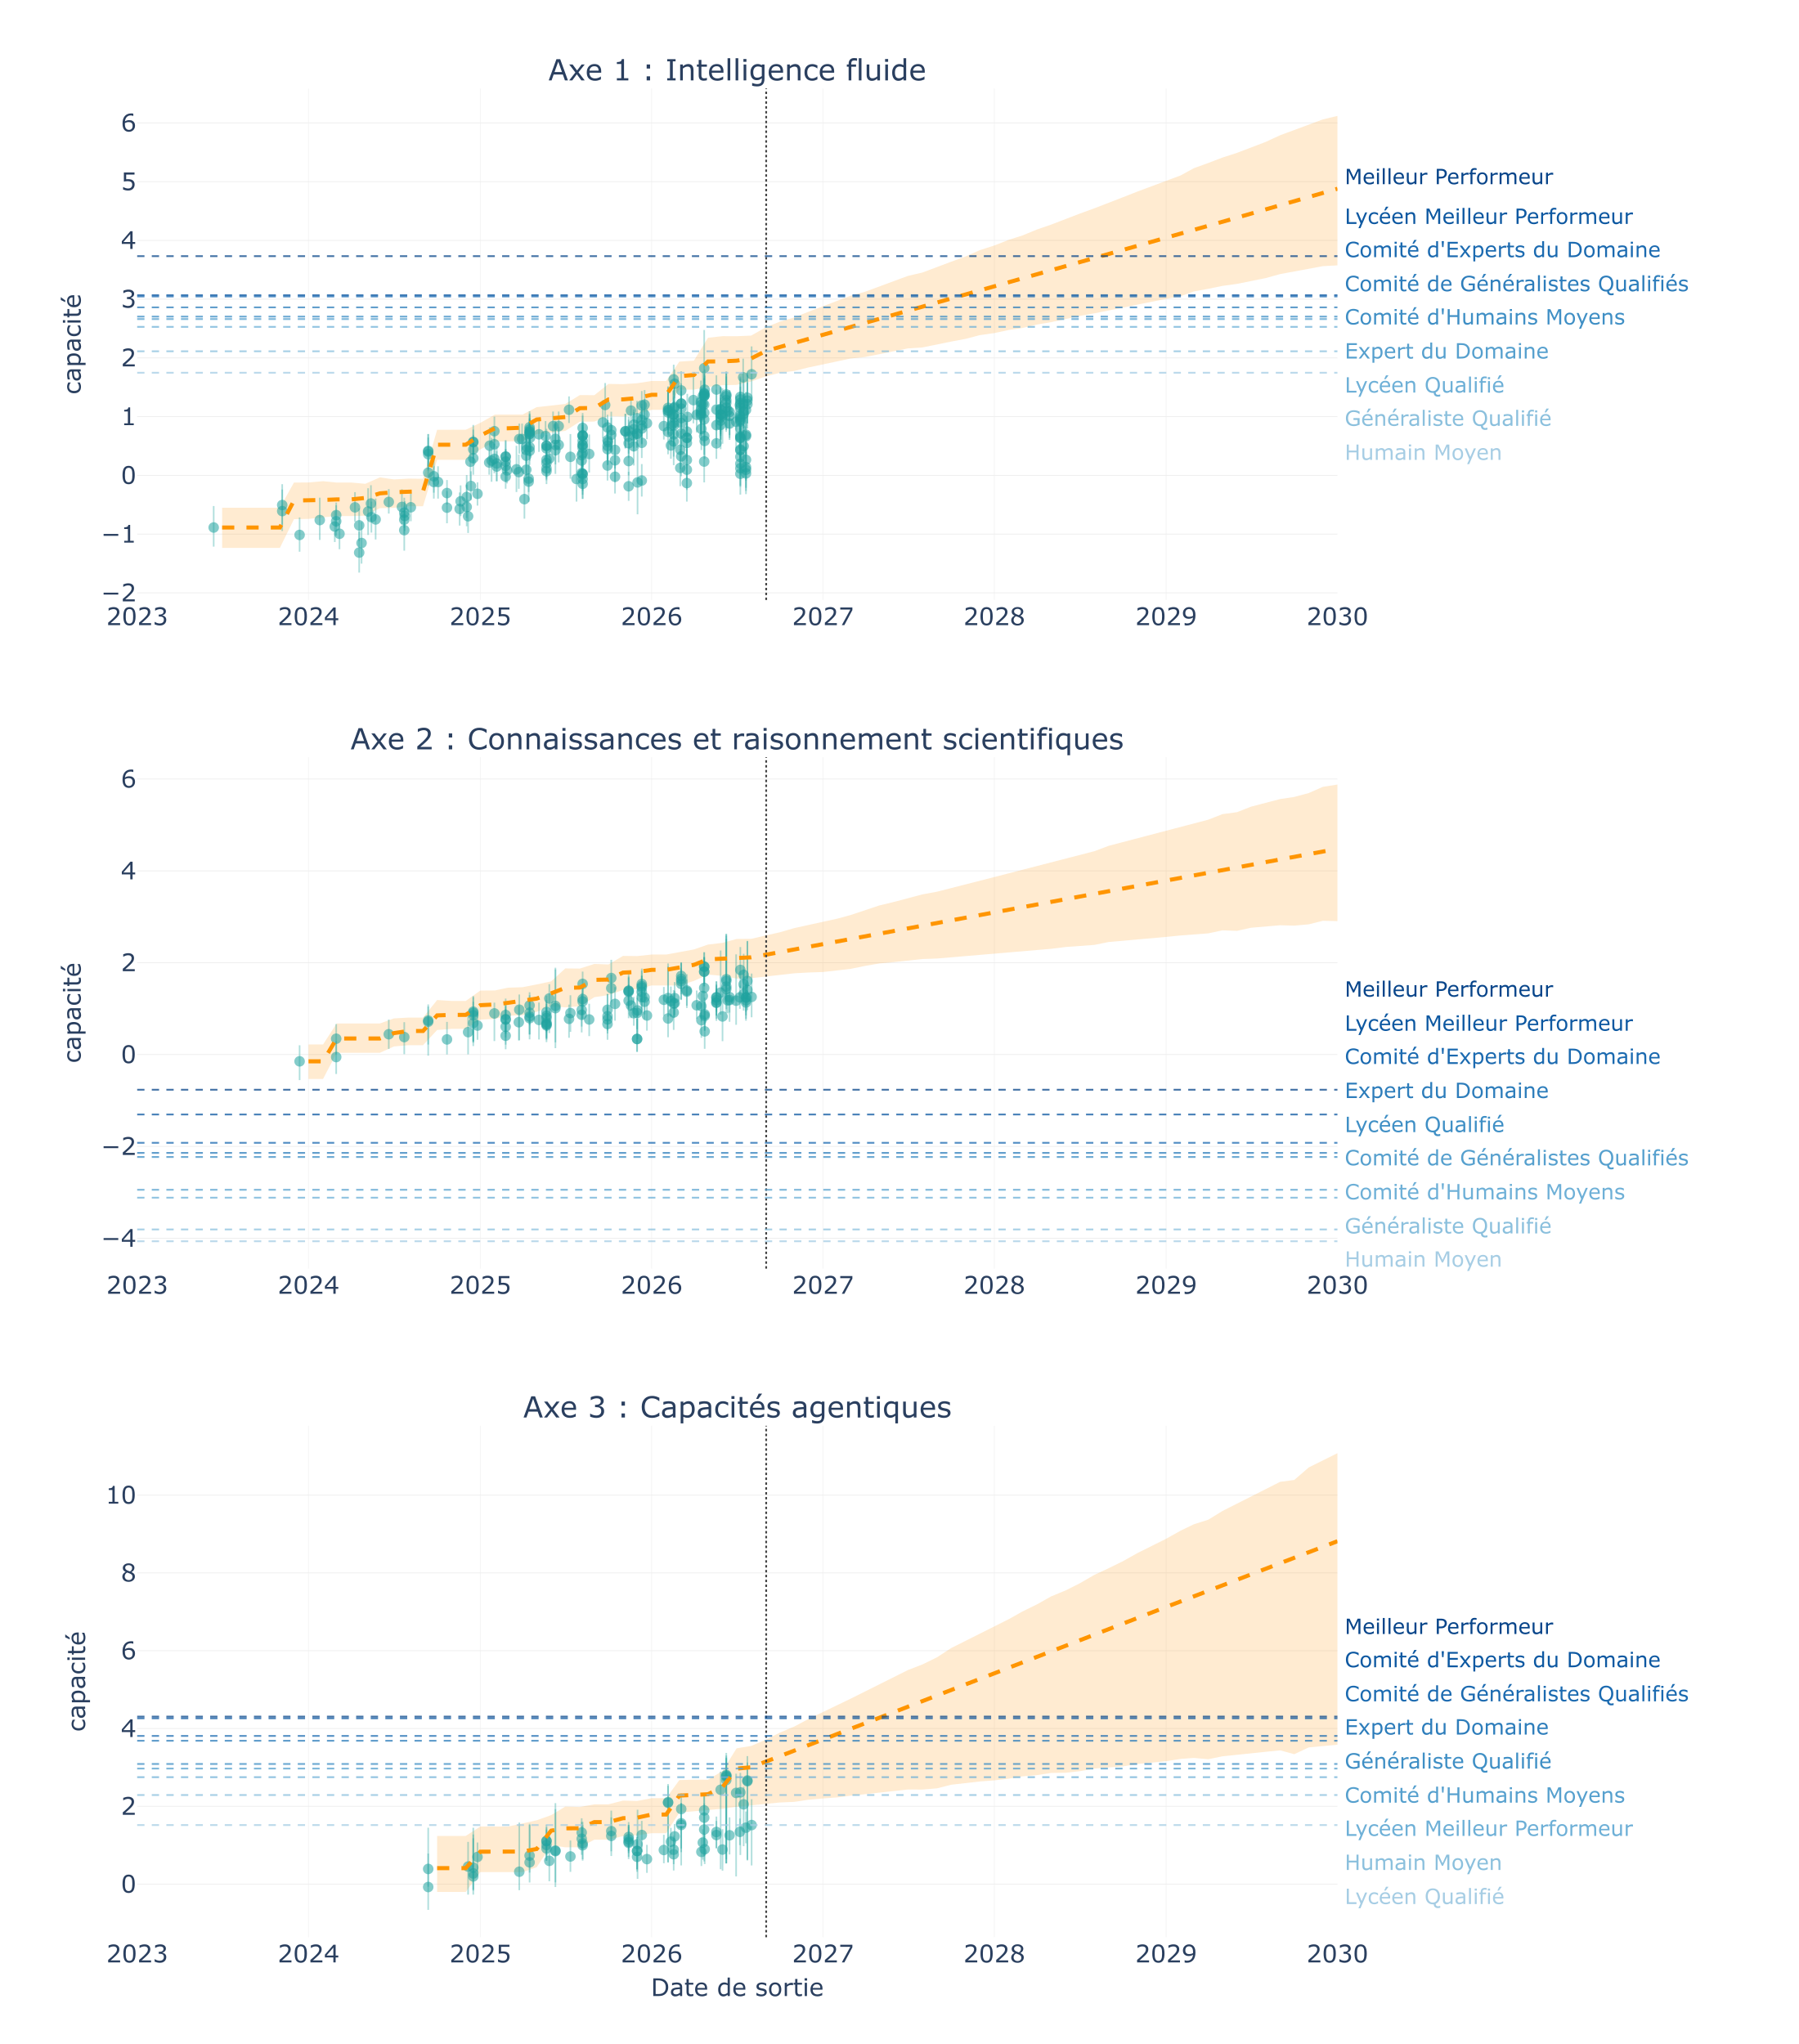
Pour ces prévisions, seuls les modèles d’IA dont la capacité sur l’axe est bien estimée entrent dans le calcul (écart-type a posteriori inférieur à 0,33, en ajoutant une sélection de modèles d’IA de frontière). Nous prenons les meilleurs modèles d’IA pour chaque axe de capacité et construisons une enveloppe des records de performances, de manière à obtenir une frontière de capacité pour chaque tirage de la distribution a posteriori. Nous prolongeons ensuite cette frontière à son rythme mesuré sur une fenêtre d’un an et demi, pour estimer quand elle atteint chaque niveau humain. Comme indiqué plus haut, les positions des modèles d’IA récents sur l’axe Questions-Réponses ne proviennent pas de capacités mesurées, donc nous excluons cet axe des projections. Les chiffres mis en avant ci-dessous correspondent au mode majoritaire obtenu à partir des données (6 chaînes sur 10, le mode minoritaire étant en annexe).
Sur l’axe Intelligence Fluide, la frontière a probablement dépassé l’Humain Moyen et se situe au niveau du Généraliste Qualifié, mais reste sous les références expertes. Elle est en passe d’atteindre l’Expert du Domaine d’ici le printemps 2027 et de dépasser le Meilleur Performeur vers mi-2028.
Sur l’axe Connaissances et Raisonnement Scientifiques, les modèles d’IA ont déjà dépassé tous les niveaux humains, avec des niveaux de certitude de 85 % à 95 %. Les données brutes confirment par exemple que sur WMDP Chimie, la référence Expert du Domaine est à 0,433 contre 0,809 pour le meilleur modèle d’IA. Sur WMDP Biologie, l’écart est de 0,605 contre 0,875, et sur GPQA Diamond de 0,812 contre 0,946. La référence Généraliste Qualifié se place sous le niveau du hasard sur GPQA Diamond, et même le doctorant du domaine n’obtient que 0,43 sur WMDP Chimie. De fait, chaque modèle d’IA sur cet axe se place au-dessus des références humaines depuis 2023. En pratique, ces résultats reflètent principalement ce que ces benchmarks récompensent, c’est-à-dire l’étendue des connaissances à travers toute une discipline, et secondairement la capacité actuelle des modèles d’IA à faire de la recherche scientifique à un niveau expert.
Sur l’axe Capacités Agentiques, les modèles d’IA ont déjà dépassé une partie des niveaux humains inférieurs, et la frontière atteint la référence du Généraliste Qualifié (nous écrivons ces lignes fin août 2026). Elle devrait dépasser le Comité d’Experts du Domaine vers mi-2027.
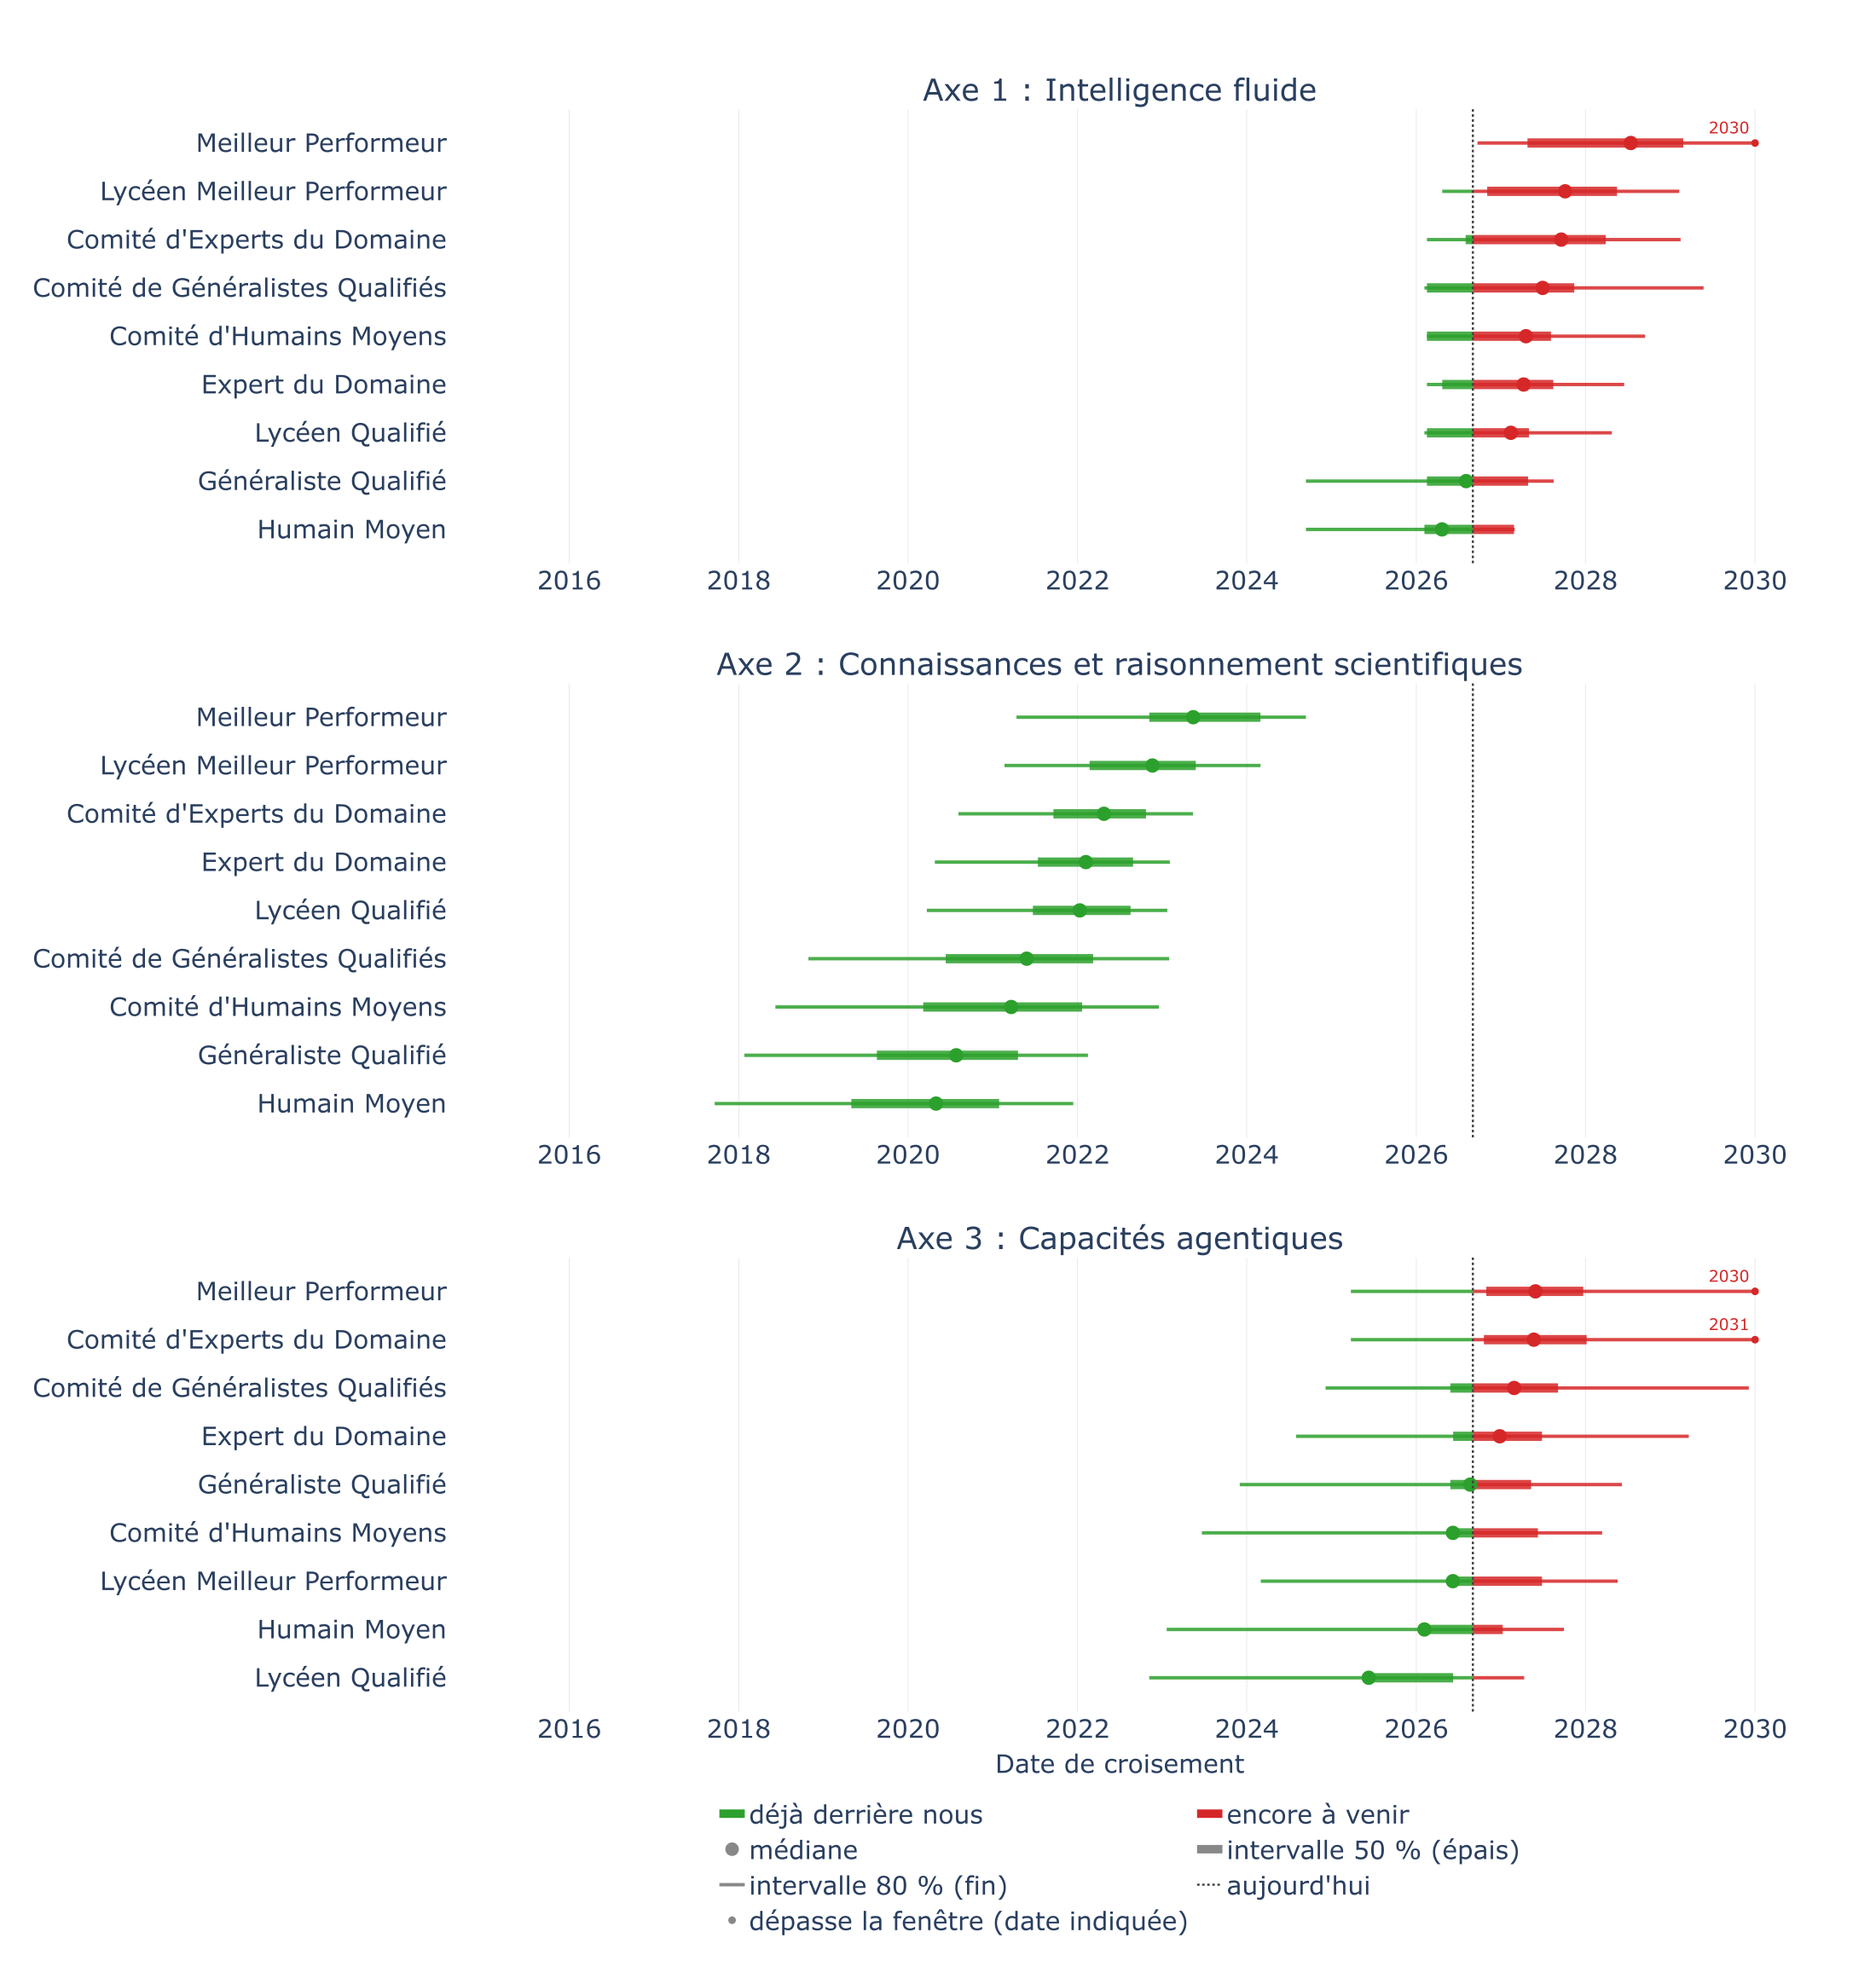
L’hypothèse principale de ces projections est que la tendance prolongée au rythme récent conserve sa pente. Cette hypothèse apparaît raisonnable dans notre fenêtre d’observation, où la frontière ne montre aucun signe de décélération et semble même accélérer sur l’axe Capacités Agentiques avec les dernières sorties. Ces dates doivent être lues avec l’incertitude que le modèle mathématique leur attache. Sur l’intervalle d’incertitude à 95 % (Annexe D), les fenêtres de croisement s’étirent de plusieurs années supplémentaires. Le meilleur moyen de resserrer ces estimations serait d’obtenir de meilleures références humaines, en particulier sur l’axe Capacités Agentiques où les niveaux humains reposent sur une poignée de mesures.
Méthodologie
Le modèle mathématique
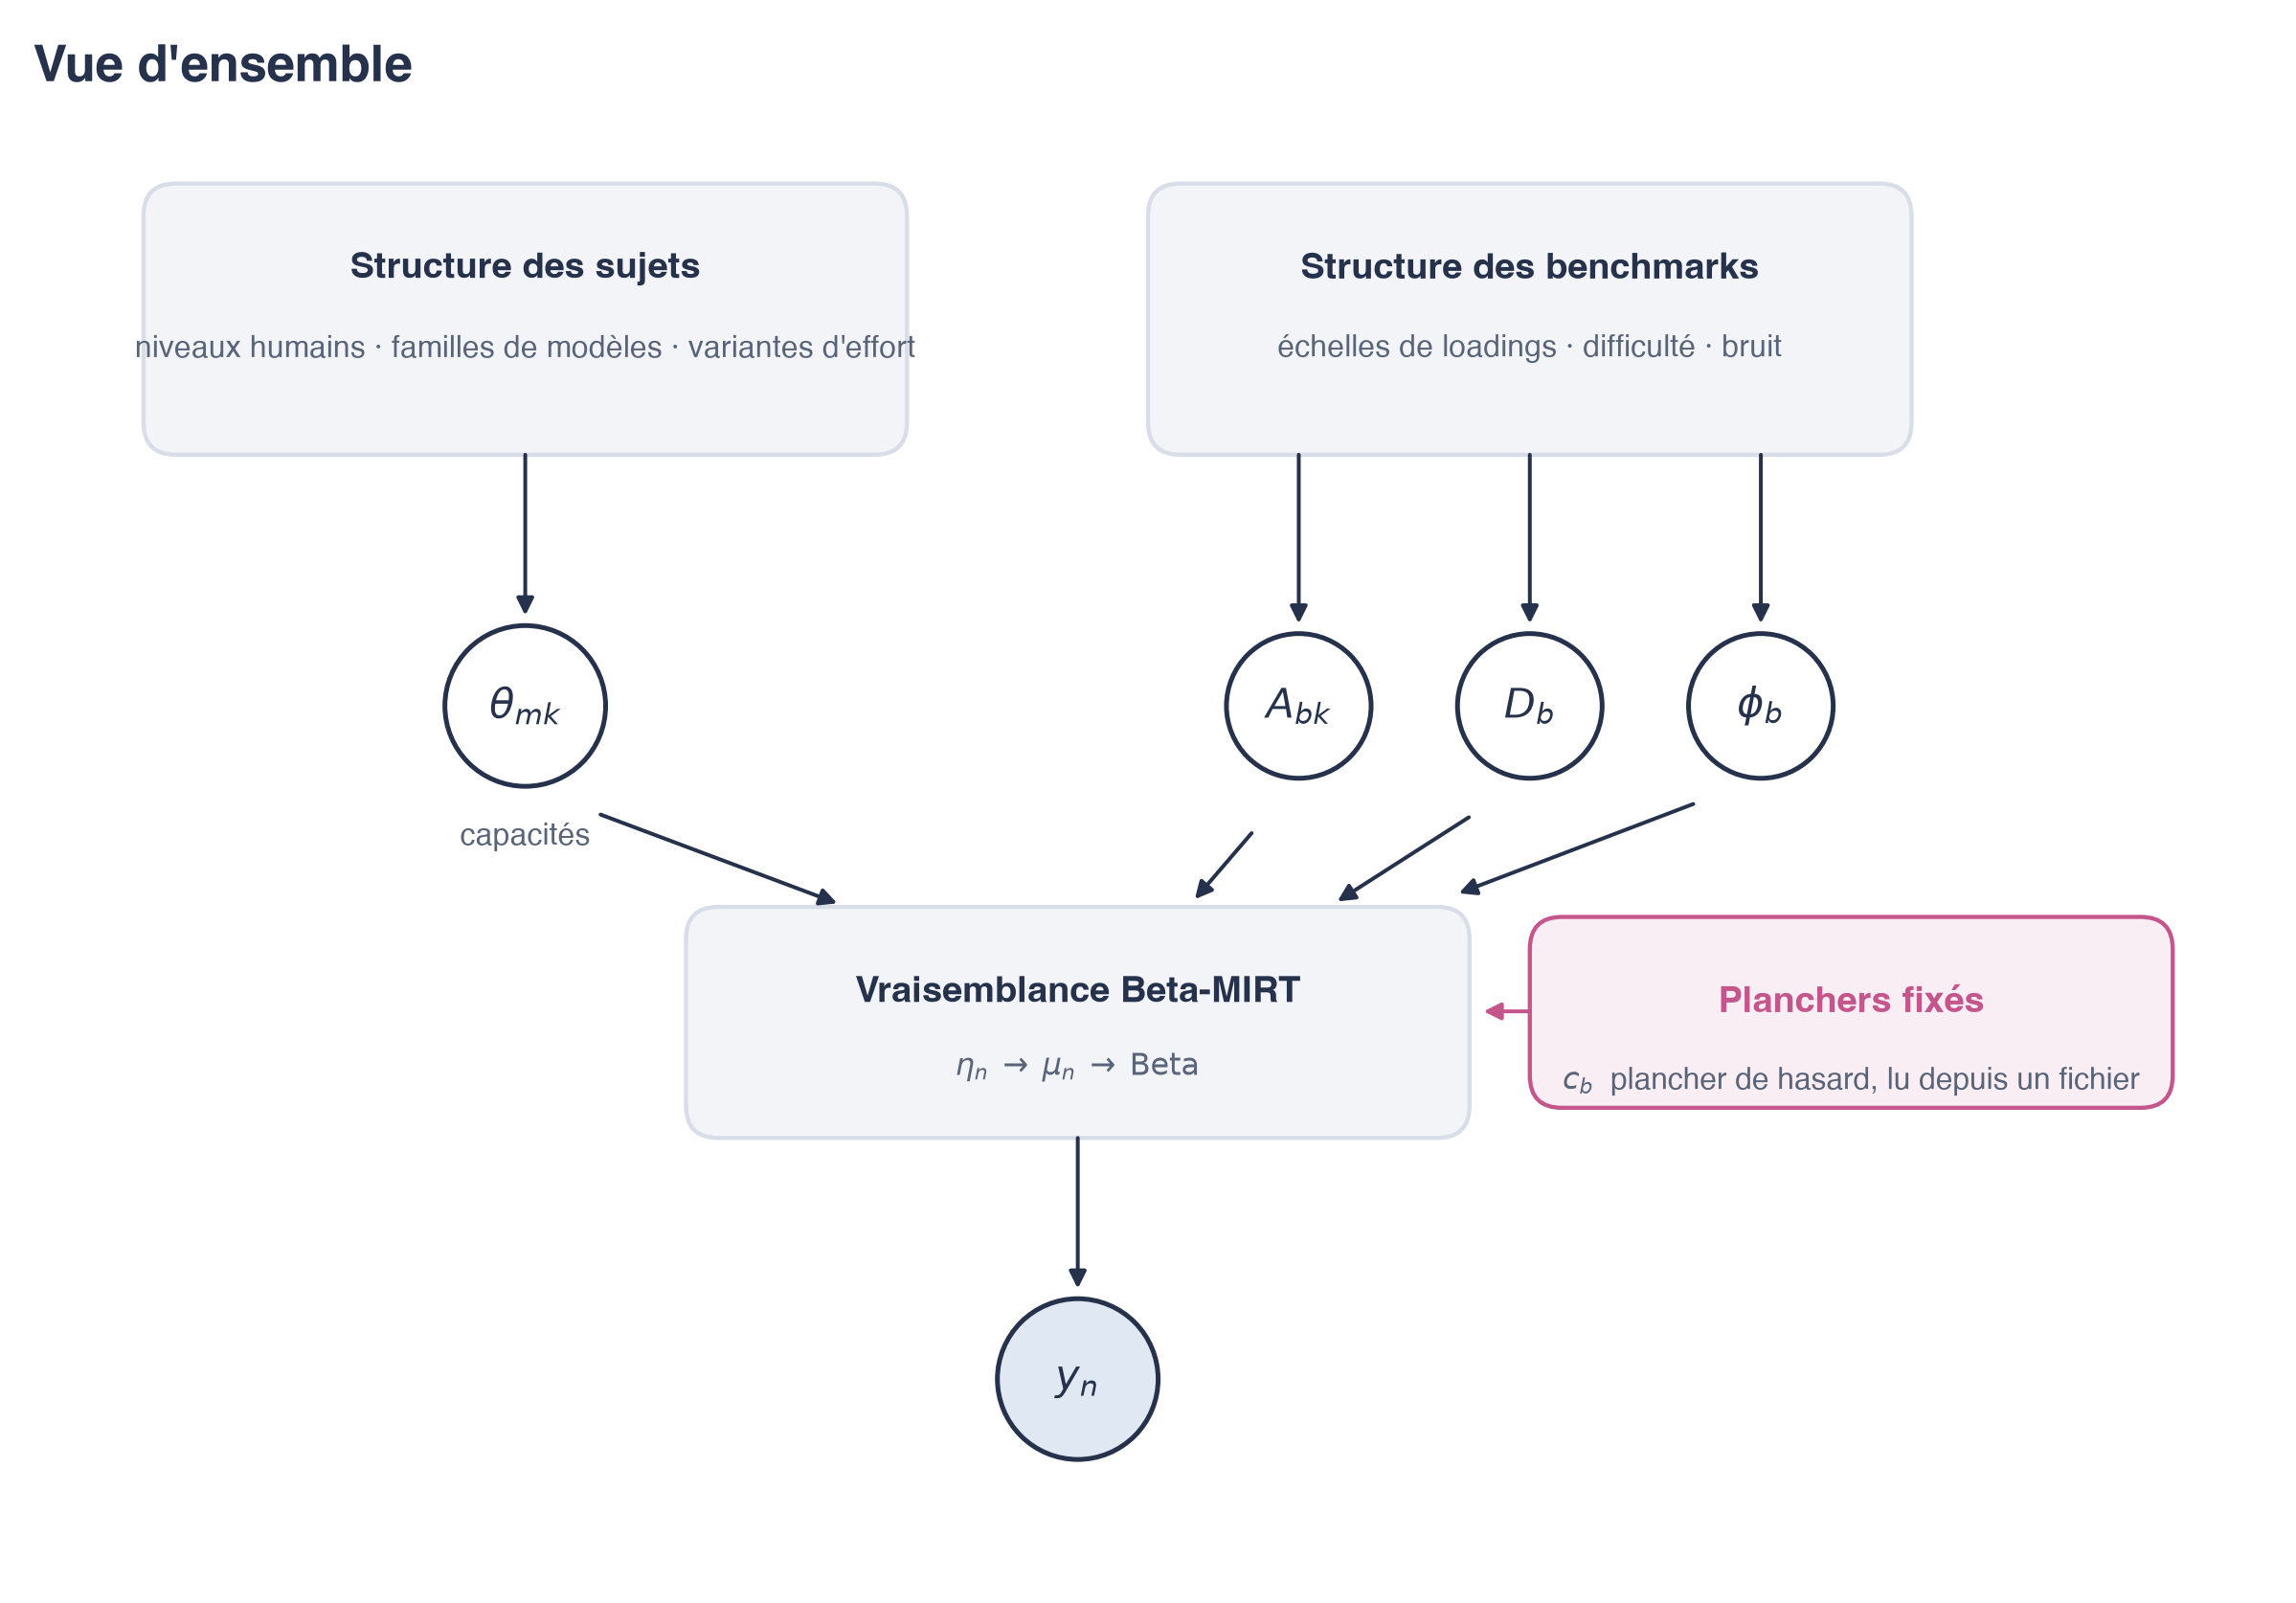
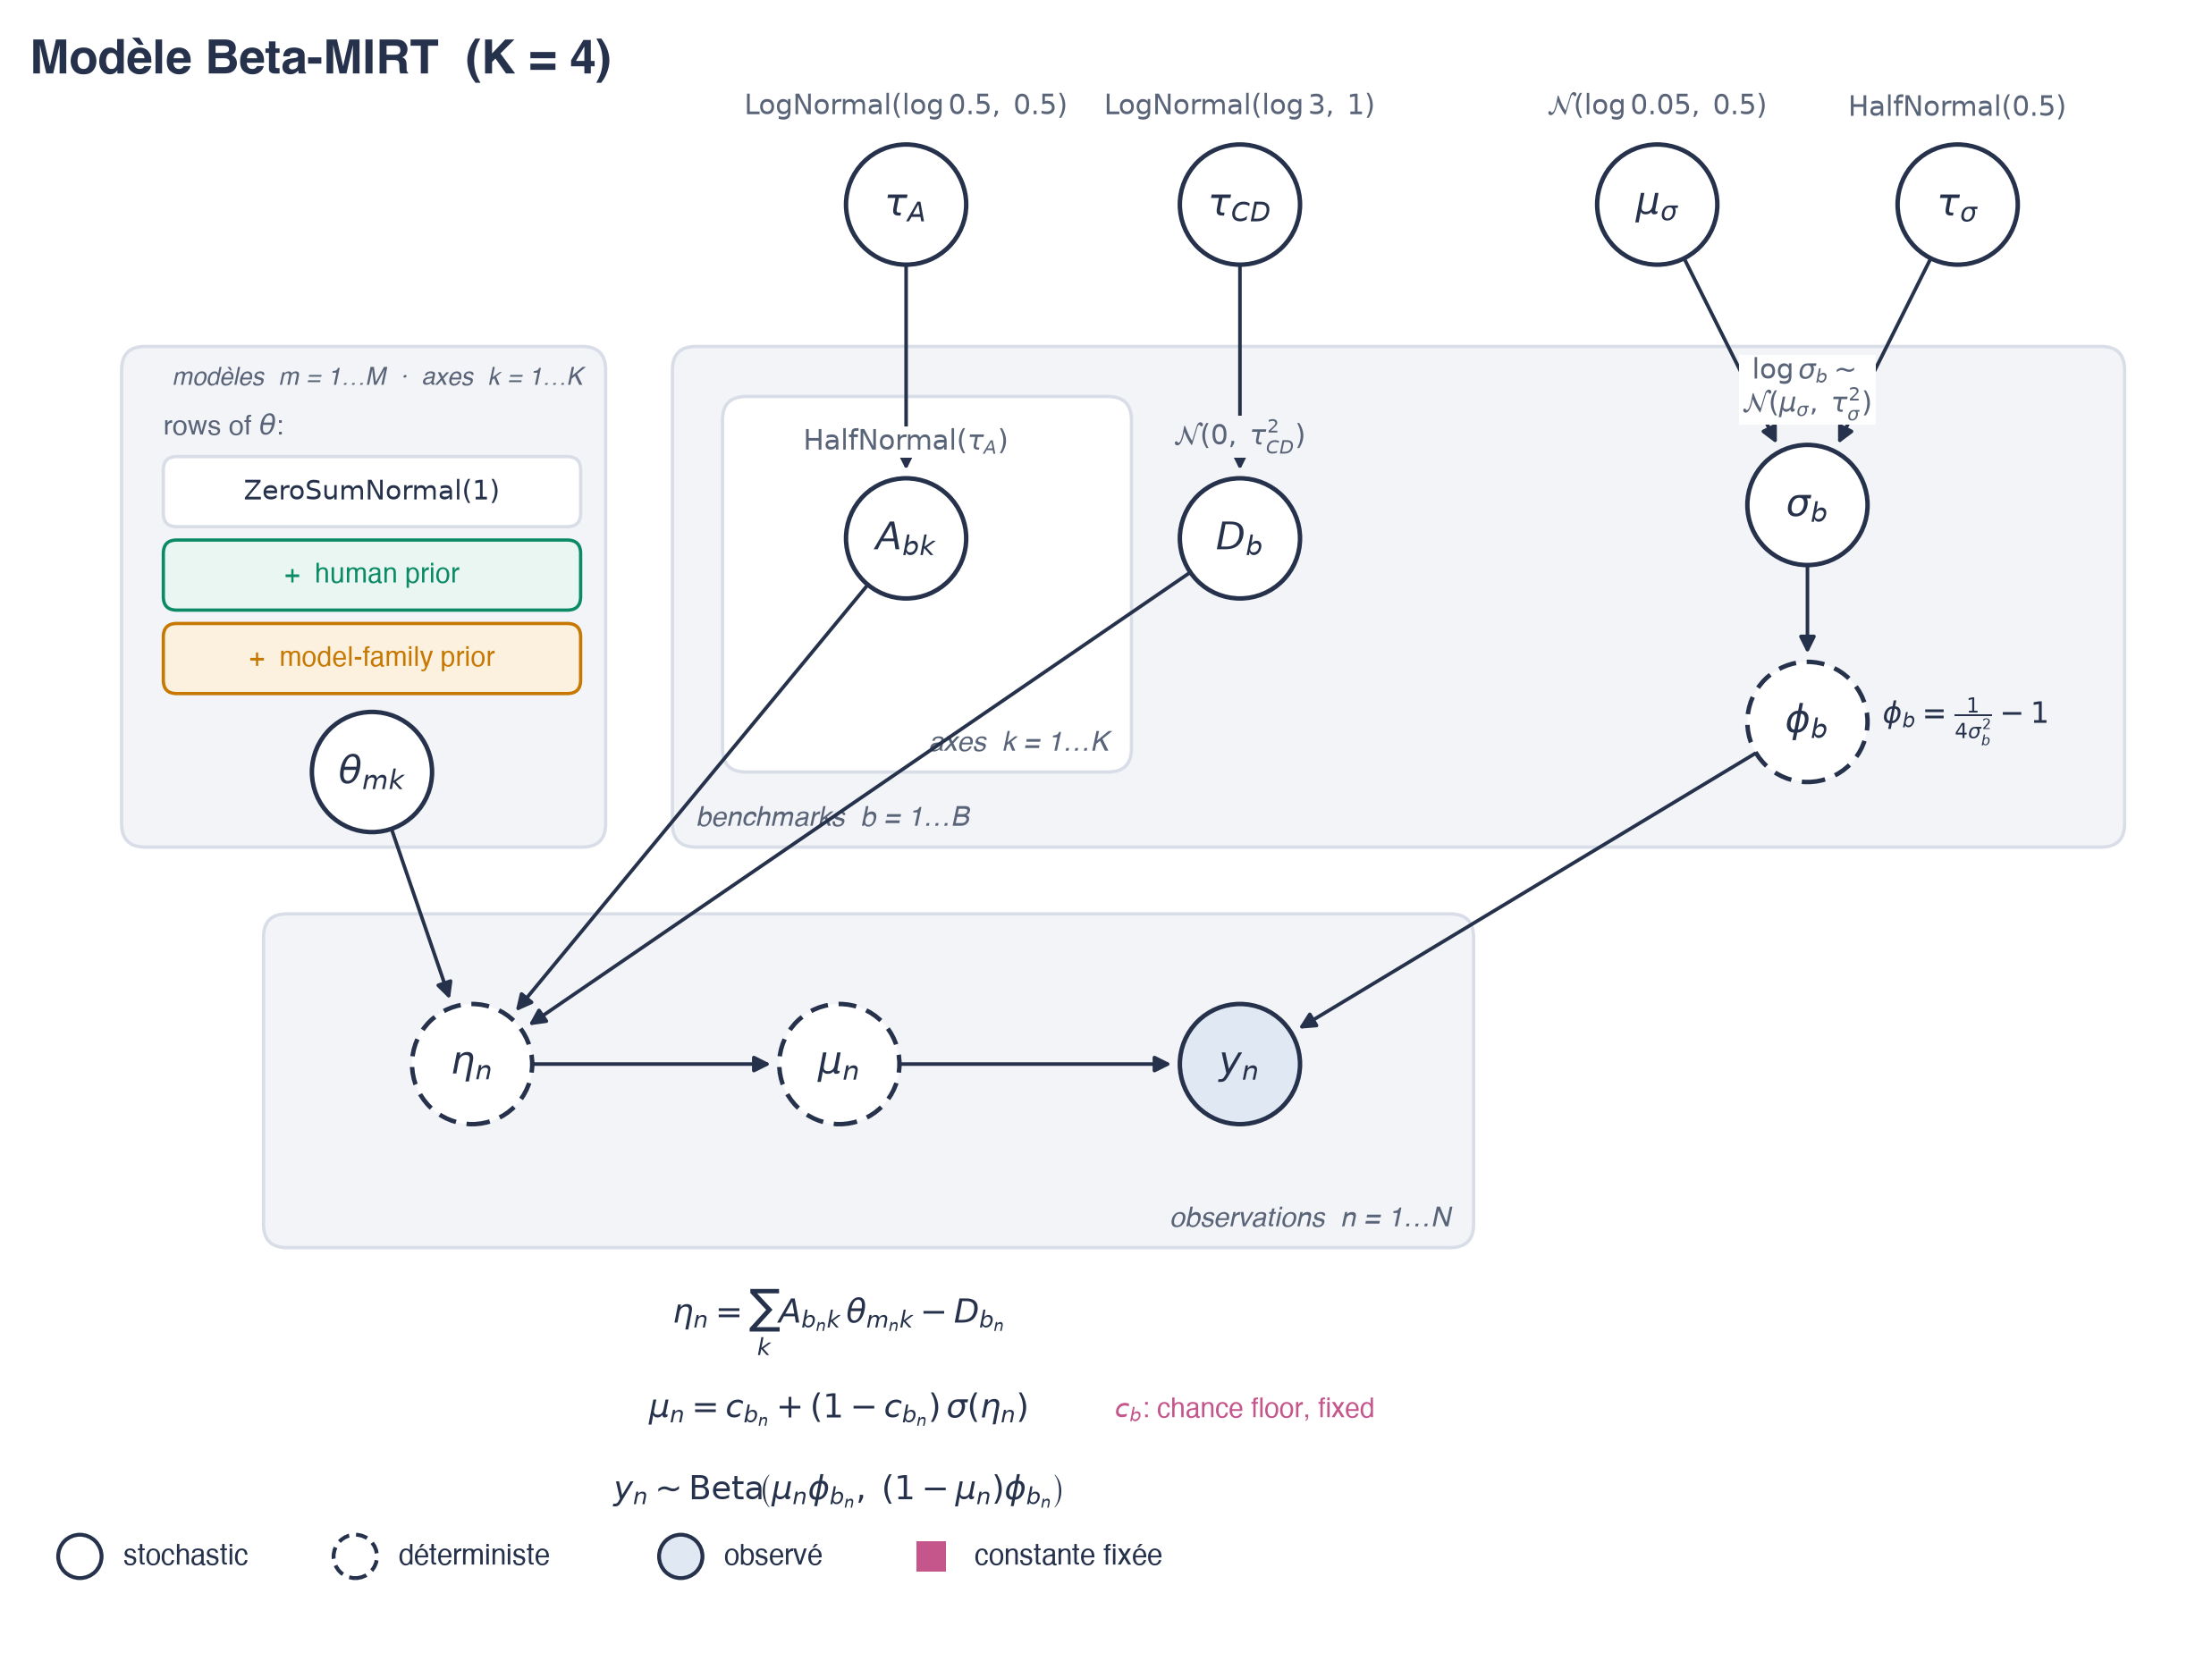
Chaque sujet m possède quatre capacités qui forment son profil de compétence. Chaque benchmark b pondère ces compétences via quatre pondérations positives (loadings), une par axe, qui représentent à quel point chaque compétence compte pour ce benchmark. Les pondérations règlent aussi dans quelle mesure un benchmark est capable de séparer les sujets passant les tests, ce que la littérature psychométrique appelle la discrimination. Un benchmark fortement pondéré distingue bien les modèles d’IA faibles des modèles d’IA forts, alors qu’un benchmark aux pondérations faibles sépare moins bien différents niveaux de compétence. La difficulté D est la barre que la somme pondérée des compétences doit franchir pour dépasser le score médian sur un benchmark donné. À la fin, une courbe sigmoïde transforme le résultat en un score entre 0 et 1. Enfin, nous intégrons la possibilité de bonnes réponses au hasard en fixant à l’avance le plancher de chance de chaque benchmark, de sorte qu’un QCM à quatre options a un score plancher de 0,25 et non de 0.
Le score attendu du sujet m sur le benchmark b s’écrit ainsi :
Le score observé fluctue autour de cette valeur avec un bruit Beta, chaque benchmark ayant son propre niveau de bruit.
La forme retenue à l’intérieur de la sigmoïde appartient à l’une des trois familles usuelles de la littérature IRT. Elle est dite compensatoire, parce qu’une compétence forte peut y compenser une compétence faible à l’intérieur de la somme. Dans la famille non compensatoire, un benchmark exige toutes ses compétences à la fois et la somme devient un produit de courbes par axe. La famille semi-compensatoire se situe entre les deux et ajoute des termes d’interaction à la somme compensatoire. Nous avons essayé les deux alternatives. L’ajustement non compensatoire n’a pas convergé, et le semi-compensatoire n’a convergé que sous de fortes contraintes et a produit de moins bonnes prédictions.
Les hypothèses a priori
Nous avons d’abord tenté d’ajuster ce modèle mathématique sans autre hypothèse que celles décrites ci-dessus, mais il ne se fixait pas sur une réponse unique. En cause, la rareté des données (la matrice sujets × benchmarks n’est remplie qu’à 6 %, et le sujet moyen ne compte qu’environ six scores) et le fait que de nombreux arrangements de capacités et de pondérations expliquent les scores aussi bien les uns que les autres. Des chaînes d’échantillonnage parallèles convergeaient donc vers des solutions différentes, et nous avons choisi d’injecter davantage d’information a priori pour l’aider à converger vers une réponse unique.
L’ordre humain (a priori strict)
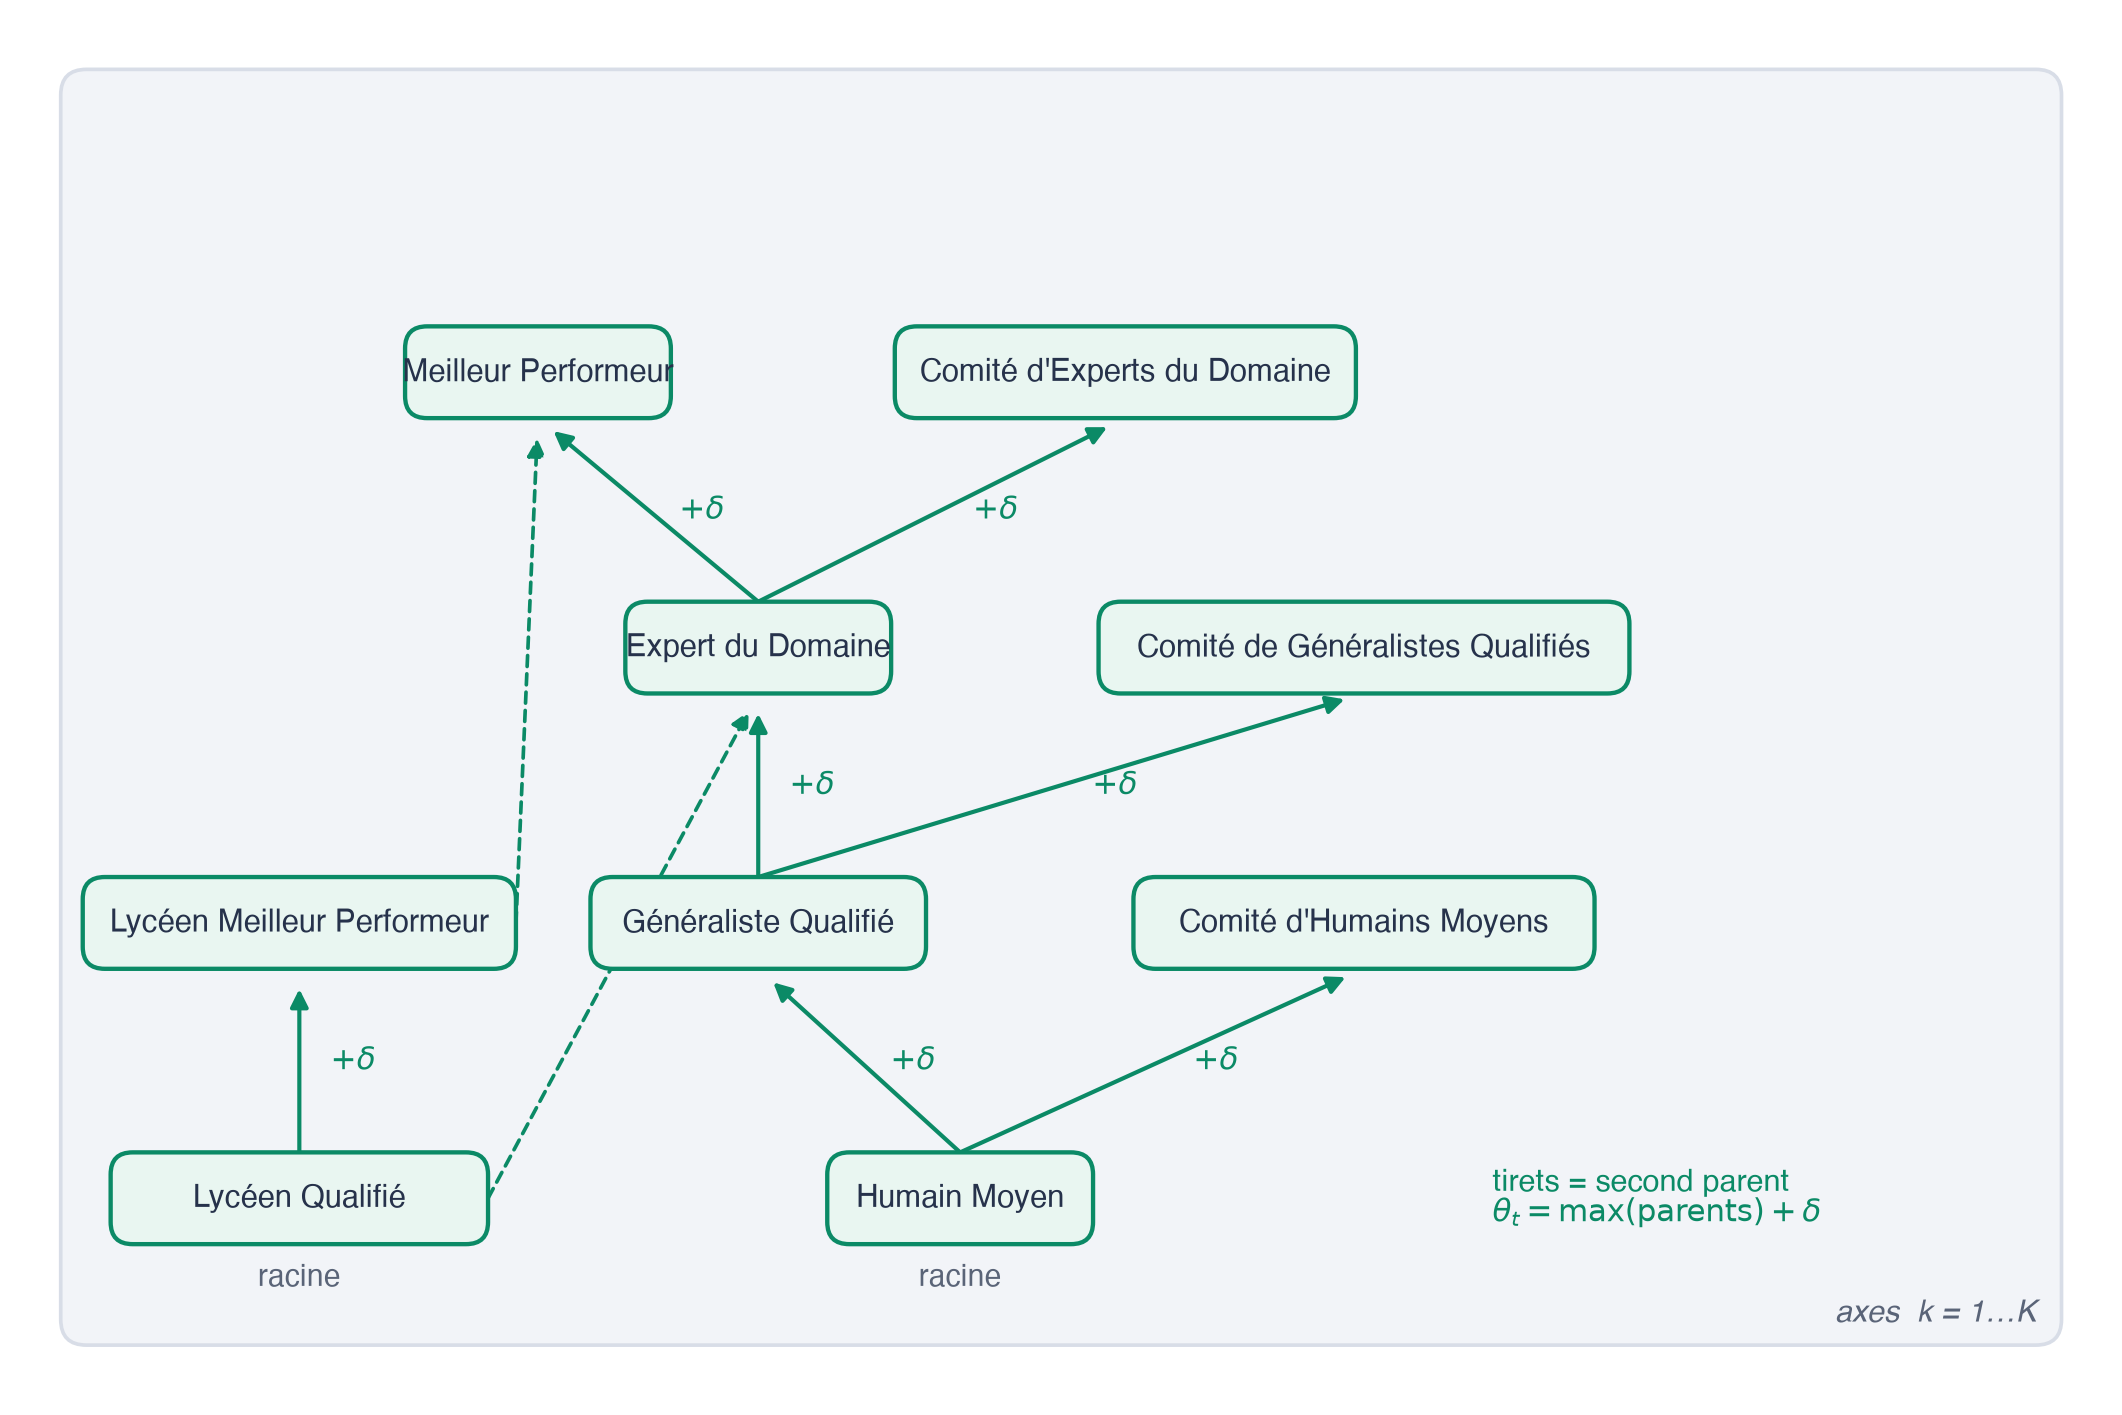
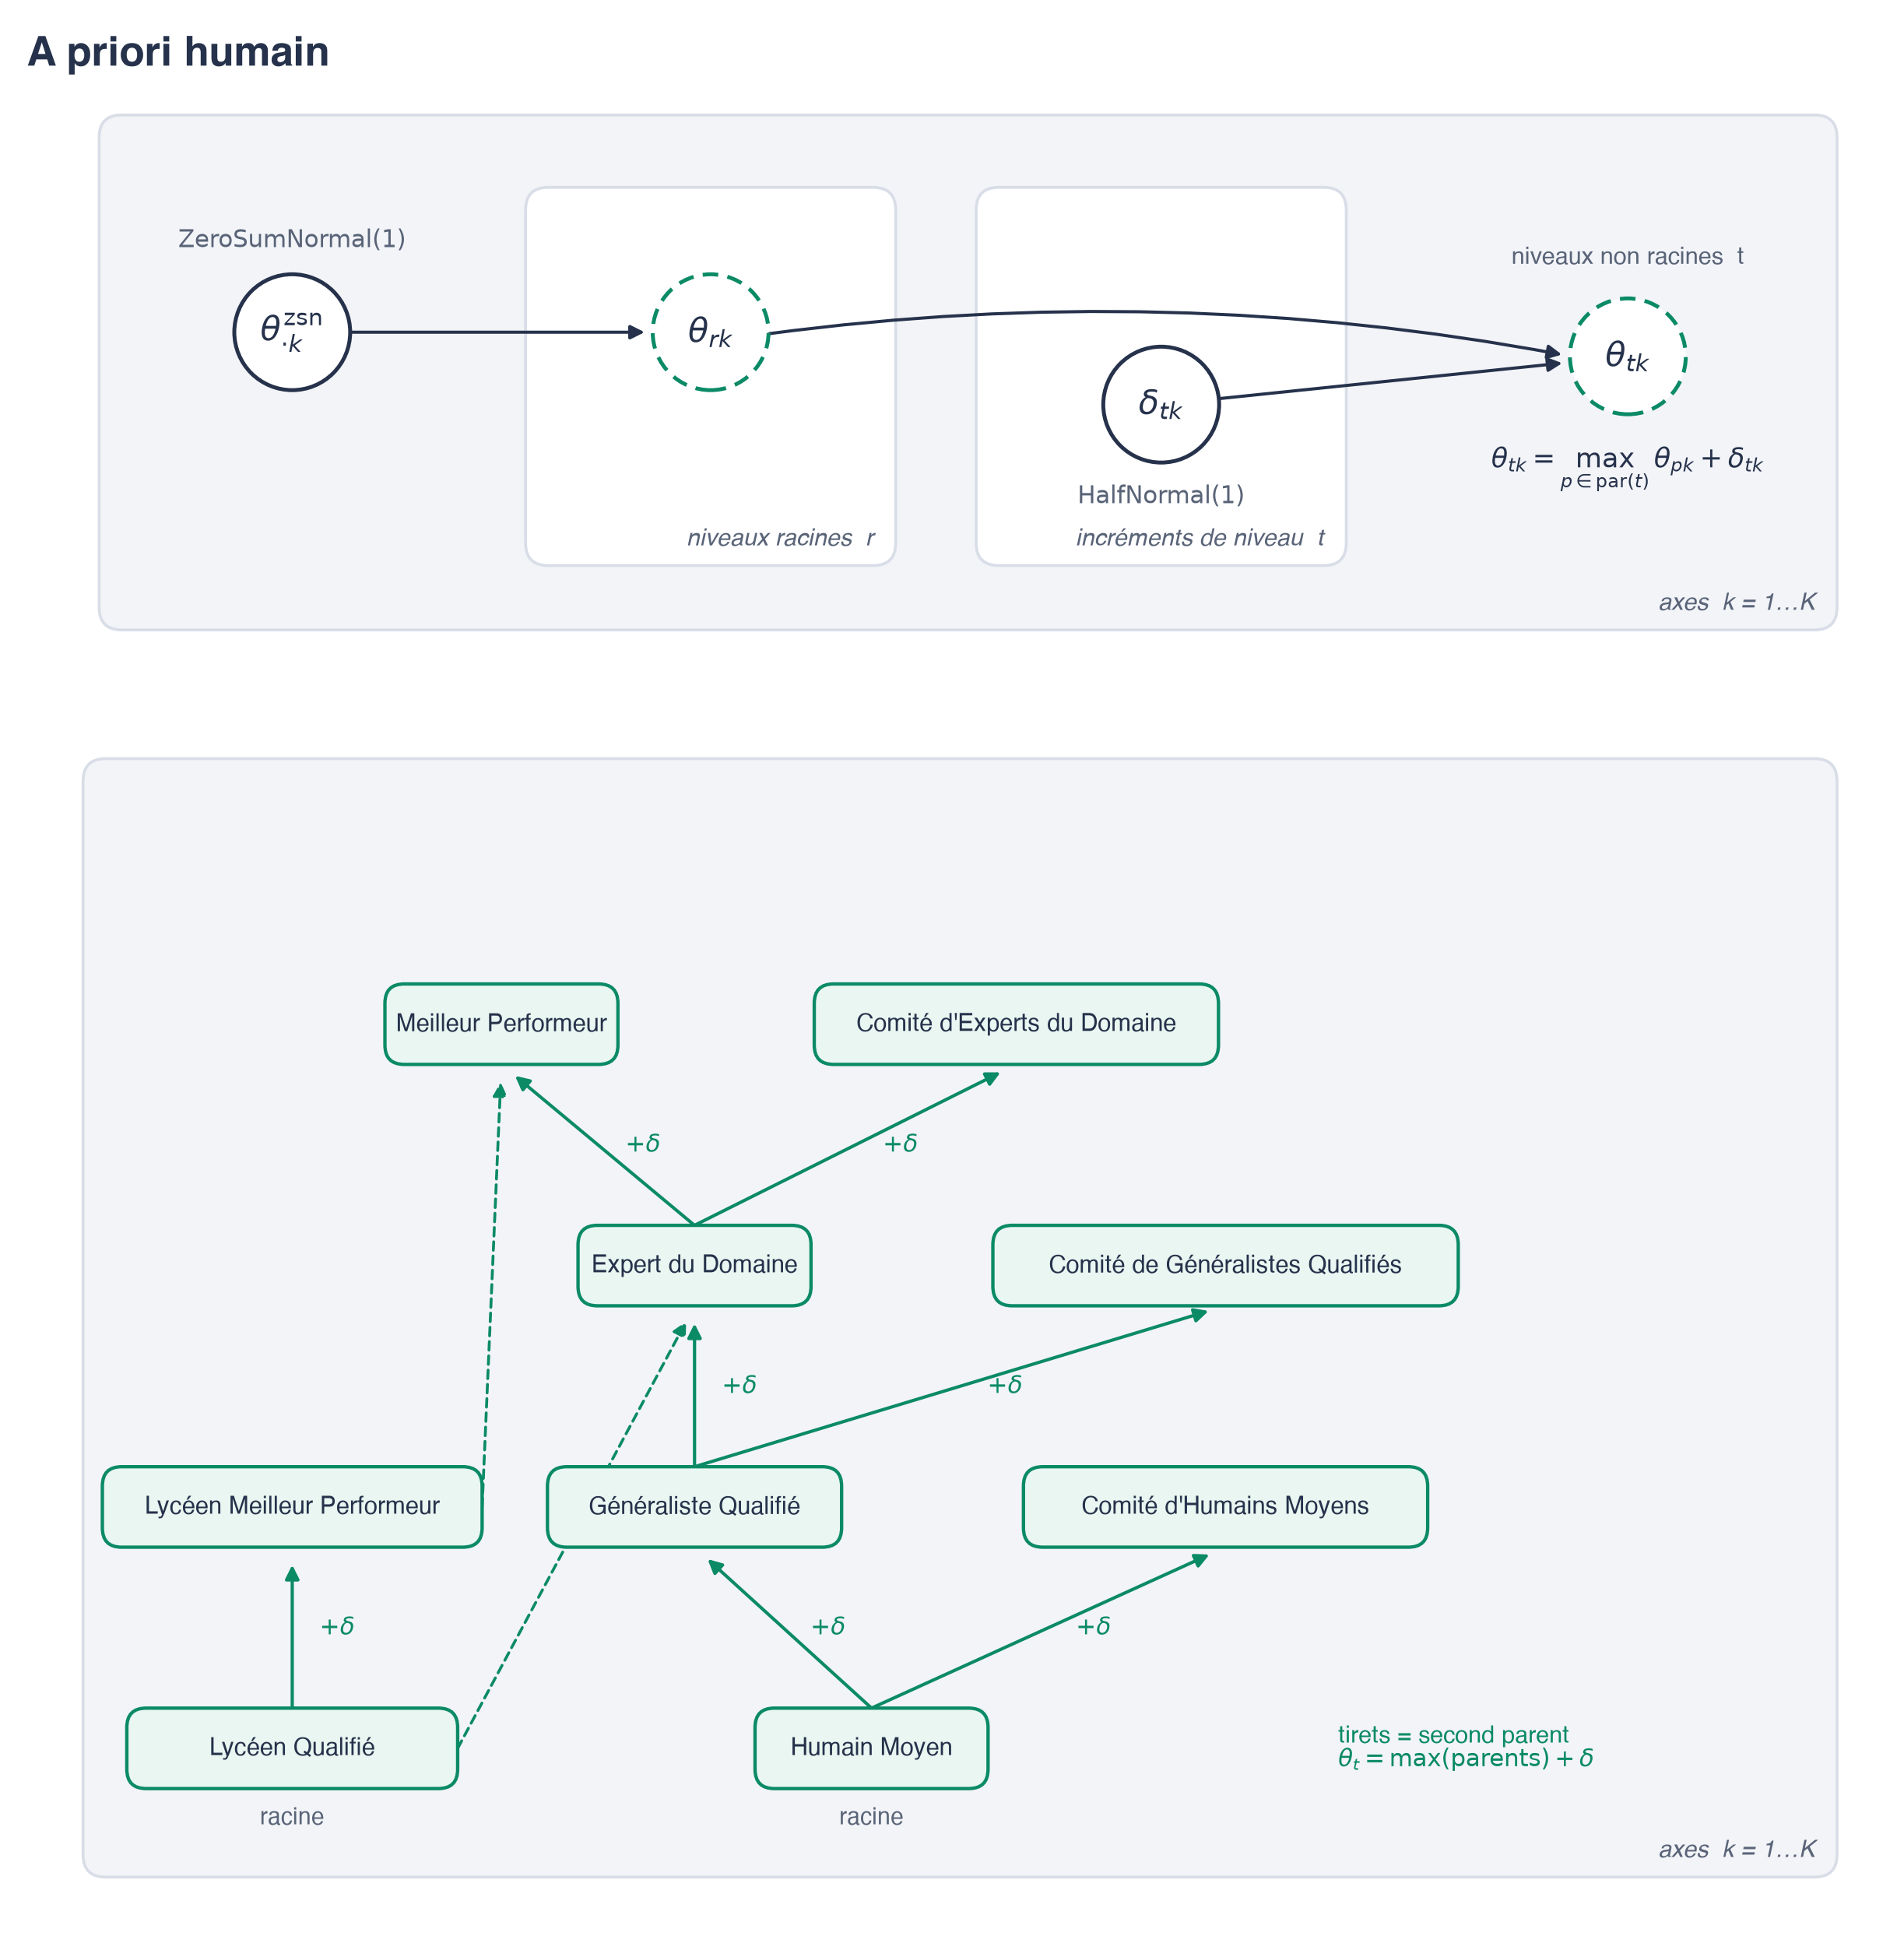
Dans les données, les humains non spécialistes ont surtout été évalués sur des benchmarks qui leur sont faciles, tandis que les experts l’ont surtout été sur des benchmarks difficiles. Or, nous savons a priori qu’un humain moyen ferait moins bien qu’un expert sur les benchmarks difficiles, et qu’un expert ferait au moins aussi bien qu’un humain moyen sur les benchmarks faciles. Ces connaissances permettent de fournir au modèle mathématique un ordre a priori. Un Expert du Domaine y est au moins aussi bon qu’un Généraliste Qualifié, et un Comité au moins aussi bon que chacun de ses membres, sur chaque compétence. L’ordre ne dit rien de la taille des écarts entre niveaux. Là où aucun classement ne s’impose, par exemple entre un Meilleur Performeur et un Comité d’Experts, nous n’imposons rien. Les deux niveaux Lycéens rejoignent l’ordre par deux liens, l’Expert du Domaine étant au moins aussi bon que le Lycéen Qualifié et le Meilleur Performeur au moins aussi bon que le Lycéen Meilleur Performeur.
Familles de modèles d’IA (a priori souple)
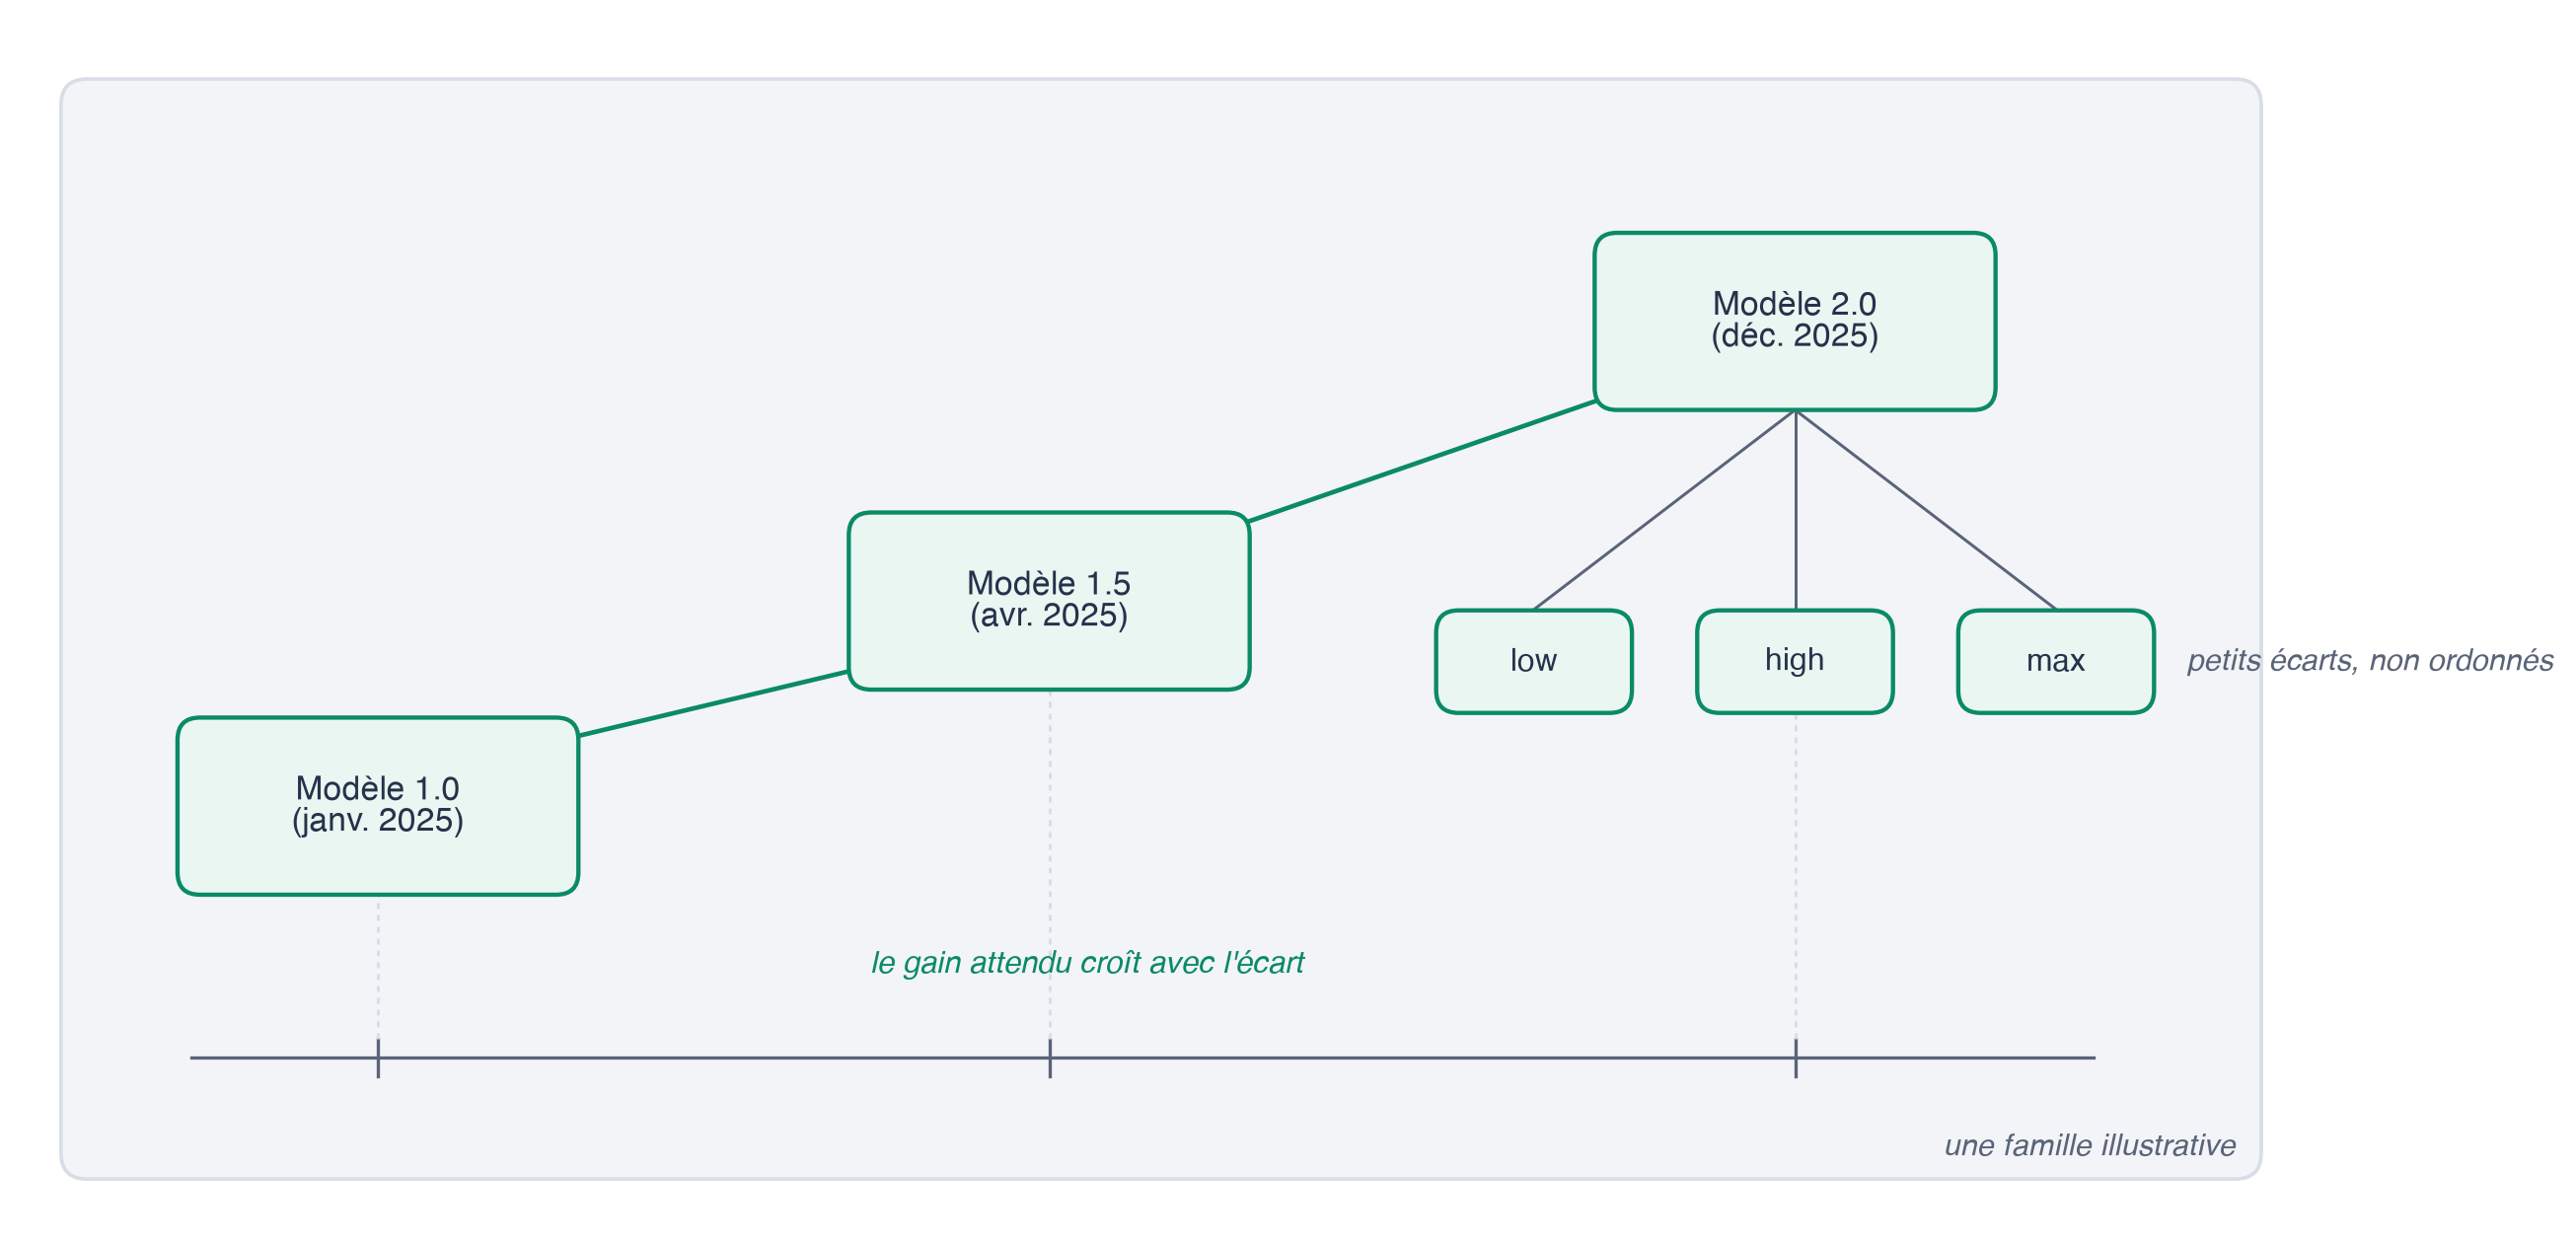
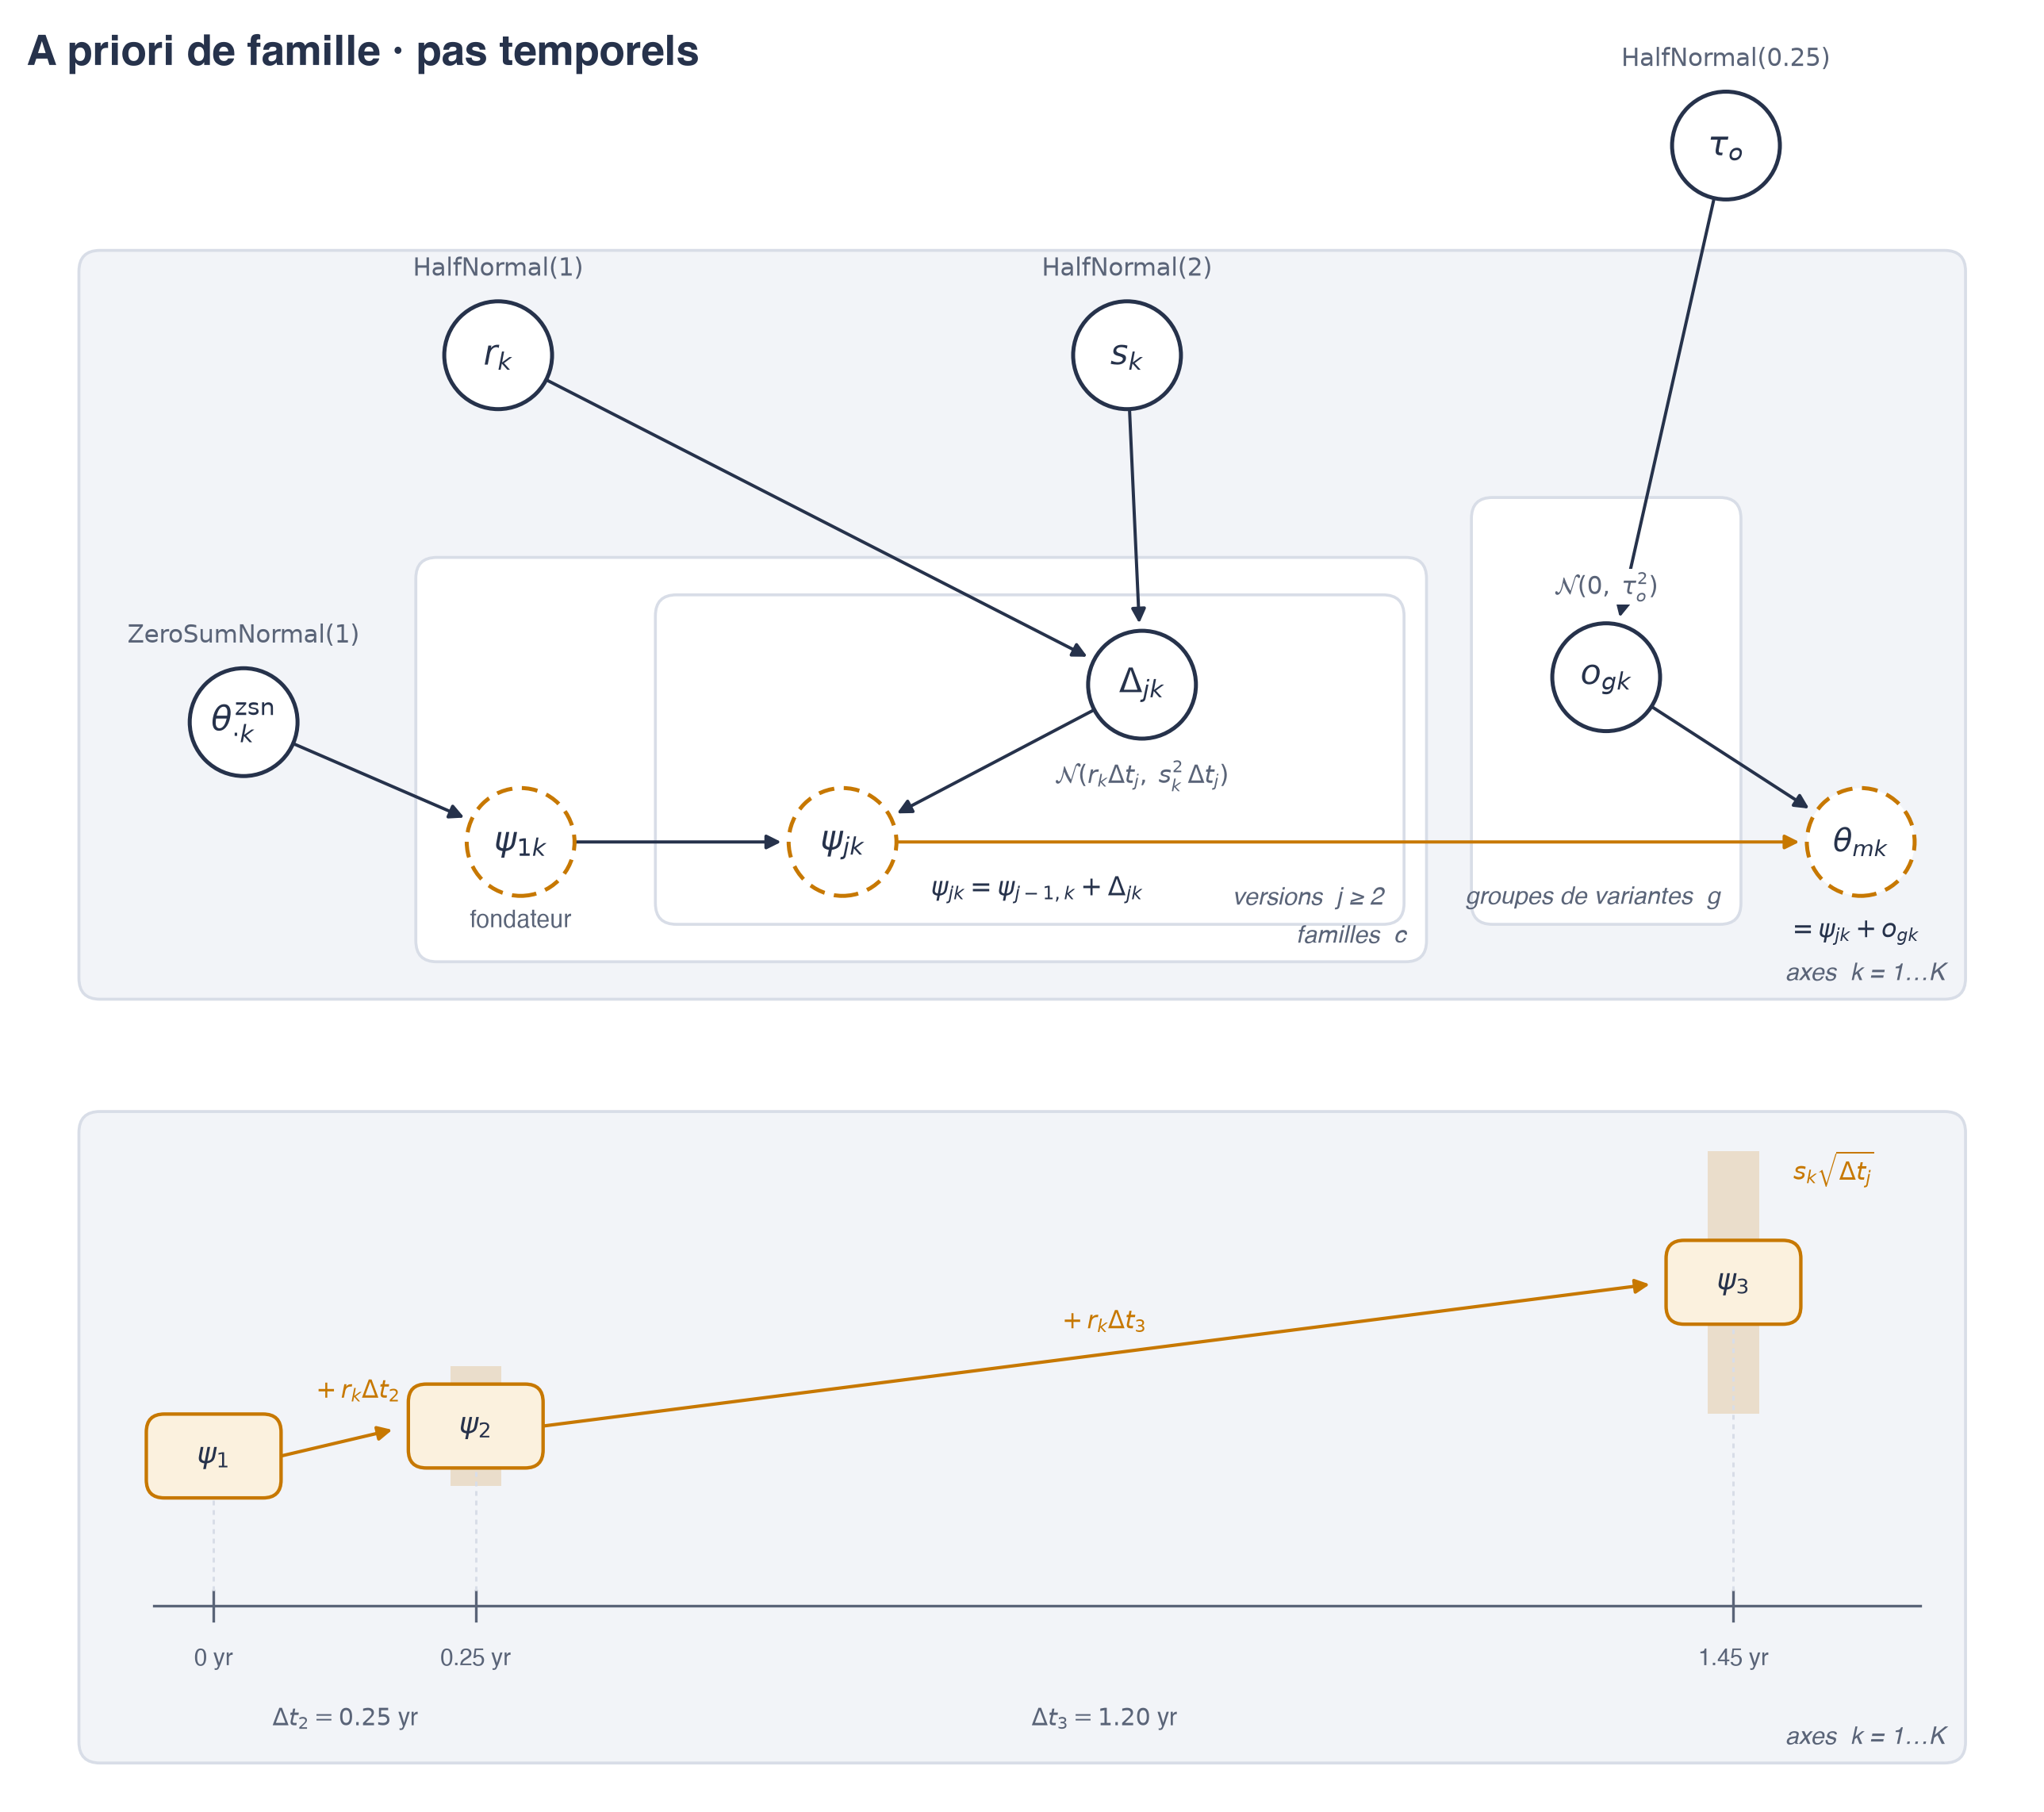
Les modèles d’IA récents manquent parfois de données pour estimer leurs capacités, mais au sein d’une même lignée, les GPT successifs ou la série Claude Opus par exemple, on peut s’attendre à ce que chaque nouvelle version améliore la précédente. Une version peut toutefois régresser si les données le justifient. Nous ne faisons que l’encourager légèrement vers l’amélioration. Nous utilisons le temps écoulé entre deux sorties pour calibrer l’écart attendu, de sorte que le gain espéré croît avec l’intervalle, et une entreprise qui publie beaucoup de petites mises à jour n’est pas supposée progresser plus vite qu’une autre qui publie une seule grosse version sur la même année. Quant aux variantes d’effort de raisonnement, elles sont rattachées à leur version de base et nous ne les ordonnons pas entre elles, un effort plus élevé pouvant conduire le modèle d’IA à trop réfléchir et dégrader ses performances.
On peut comparer les variantes de modélisation pour mesurer ce que ces a priori apportent. Sans aucun a priori, les résultats se séparent en deux systèmes d’axes différents. Avec l’ordre humain seul, il reste deux solutions en désaccord sur les axes. C’est l’ajout de l’hypothèse de famille qui met enfin toutes les chaînes d’échantillonnage d’accord sur un même système d’axes. Nous avons aussi essayé trois axes avec toutes les hypothèses activées, et les chaînes se séparent encore en deux groupes de résultats possibles. Ces hypothèses améliorent par ailleurs la capacité prédictive du modèle mathématique. Sur une validation croisée, dite leave-one-out, le modèle final bat la version sans a priori d’environ 107 ± 18 points et l’indice unidimensionnel d’environ 1 000 ± 33, en comparant sur les lignes où la comparaison est fiable.
Limites
La première limite tient aux données elles-mêmes. Comme expliqué dans le billet précédent, il en faut davantage et de meilleure qualité, pour les références humaines d’abord, mais aussi pour les systèmes d’IA. Nous ne remplissons que 6 % de la matrice sujets × benchmarks, et cette rareté nous a contraints à ajouter des hypothèses de modélisation.
La deuxième, que nous partageons avec l’article Rosetta Stone et l’ECI en général, est que nous ajustons des scores agrégés par benchmark plutôt que des réponses question par question. Les hypothèses du cadre MIRT ne sont donc pas pleinement respectées.
La dernière concerne la calibration. Nos intervalles prédictifs sont plus larges que ce que les données exigent, ce qui rend les résultats plus prudents qu’ils ne devraient l’être.
Pistes de travail
Au-delà de la collecte de données supplémentaires, quelques directions valent la peine d’être explorées.
- Faire passer les benchmarks saturés aux systèmes d’IA de frontière actuels. Cela permettrait de trancher l’axe Questions-Réponses avec des données plutôt que de le laisser à l’état d’artefact, tout en remplissant la grille des données.
- Des plafonds sur les benchmarks saturés. Nous fixons déjà un plancher de hasard par benchmark. Un plafond, inféré des données ou fixé, permettrait de lire la saturation comme telle et non comme une difficulté extrême.
- Tester les projections dans les deux sens. Répliquer la méthode sur un sous-échantillon plus ancien des données et confronter ses prévisions aux sorties advenues depuis.
Annexe A - Spécification graphique du modèle mathématique
Annexe B - Les ajustements précédents
Cette annexe consigne les ajustements précédents et l’effet de chaque hypothèse sur le modèle mathématique. Pour l’échelle unidimensionnelle, nous utilisons tous les benchmarks afin de le comparer à l’ajustement final.
| Ajustement | Chaînes × tirages | Divergences | Modes postérieurs | elpd (LOO) ± erreur | Δ vs final (a) |
|---|---|---|---|---|---|
| Indice unidimensionnel | 10 × 10 000 | 0 | 1 | 6 249,6 ± 112,1 | −999,6 ± 33,2 |
| 4 axes, sans a priori | 12 × 3 000 | 778 | 2 | 7 583,9 ± 75,9 | −107,2 ± 18,3 |
| 4 axes, ordre humain seul | 12 × 3 000 | 80 | 2 | 7 583,3 ± 73,1 | −109,2 ± 17,2 |
| 4 axes, les deux a priori | 10 × 12 000 | 37 (b) | 1 (c) | 7 710,4 ± 76,3 | 0 |
| 3 axes, les deux a priori | 12 × 3 000 | 12 | 2 (d) | 7 447,8 ± 77,4 | −191,1 ± 14,3 |
(a) Les écarts en leave-one-out appariés n’utilisent que les lignes dont le Pareto-k est inférieur à 0,7 dans les deux ajustements.
(b) Ces divergences sont mineures et ne concernent qu’un paramètre associé au benchmark GSM8K.
(c) Les deux groupes de chaînes partagent un même système d’axes et ne diffèrent que sur les niveaux humains et 18 modèles d’IA anciens ou peu évalués de l’axe Capacités Agentiques (Annexe C), contrairement aux autres ajustements, qui ne s’accordent pas sur les axes.
(d) À trois axes, avec toutes les hypothèses, dix chaînes se séparent contre deux, en échangeant deux des axes entre les solutions.
Annexe C - Le mode minoritaire
Quatre des dix chaînes d’échantillonnage placent les niveaux humains différemment. Cette annexe consigne ce qui bouge et comment les prévisions changent.
L’écart entre le mode minoritaire et le mode majoritaire, moyenné sur les neuf niveaux, s’établit à +0,71 sur l’Intelligence Fluide, −0,04 sur les Connaissances et Raisonnement Scientifiques, −2,71 sur les Capacités Agentiques et +1,58 sur les Questions-Réponses. Les deux groupes partagent un même système d’axes et décrivent les scores aussi bien l’un que l’autre.
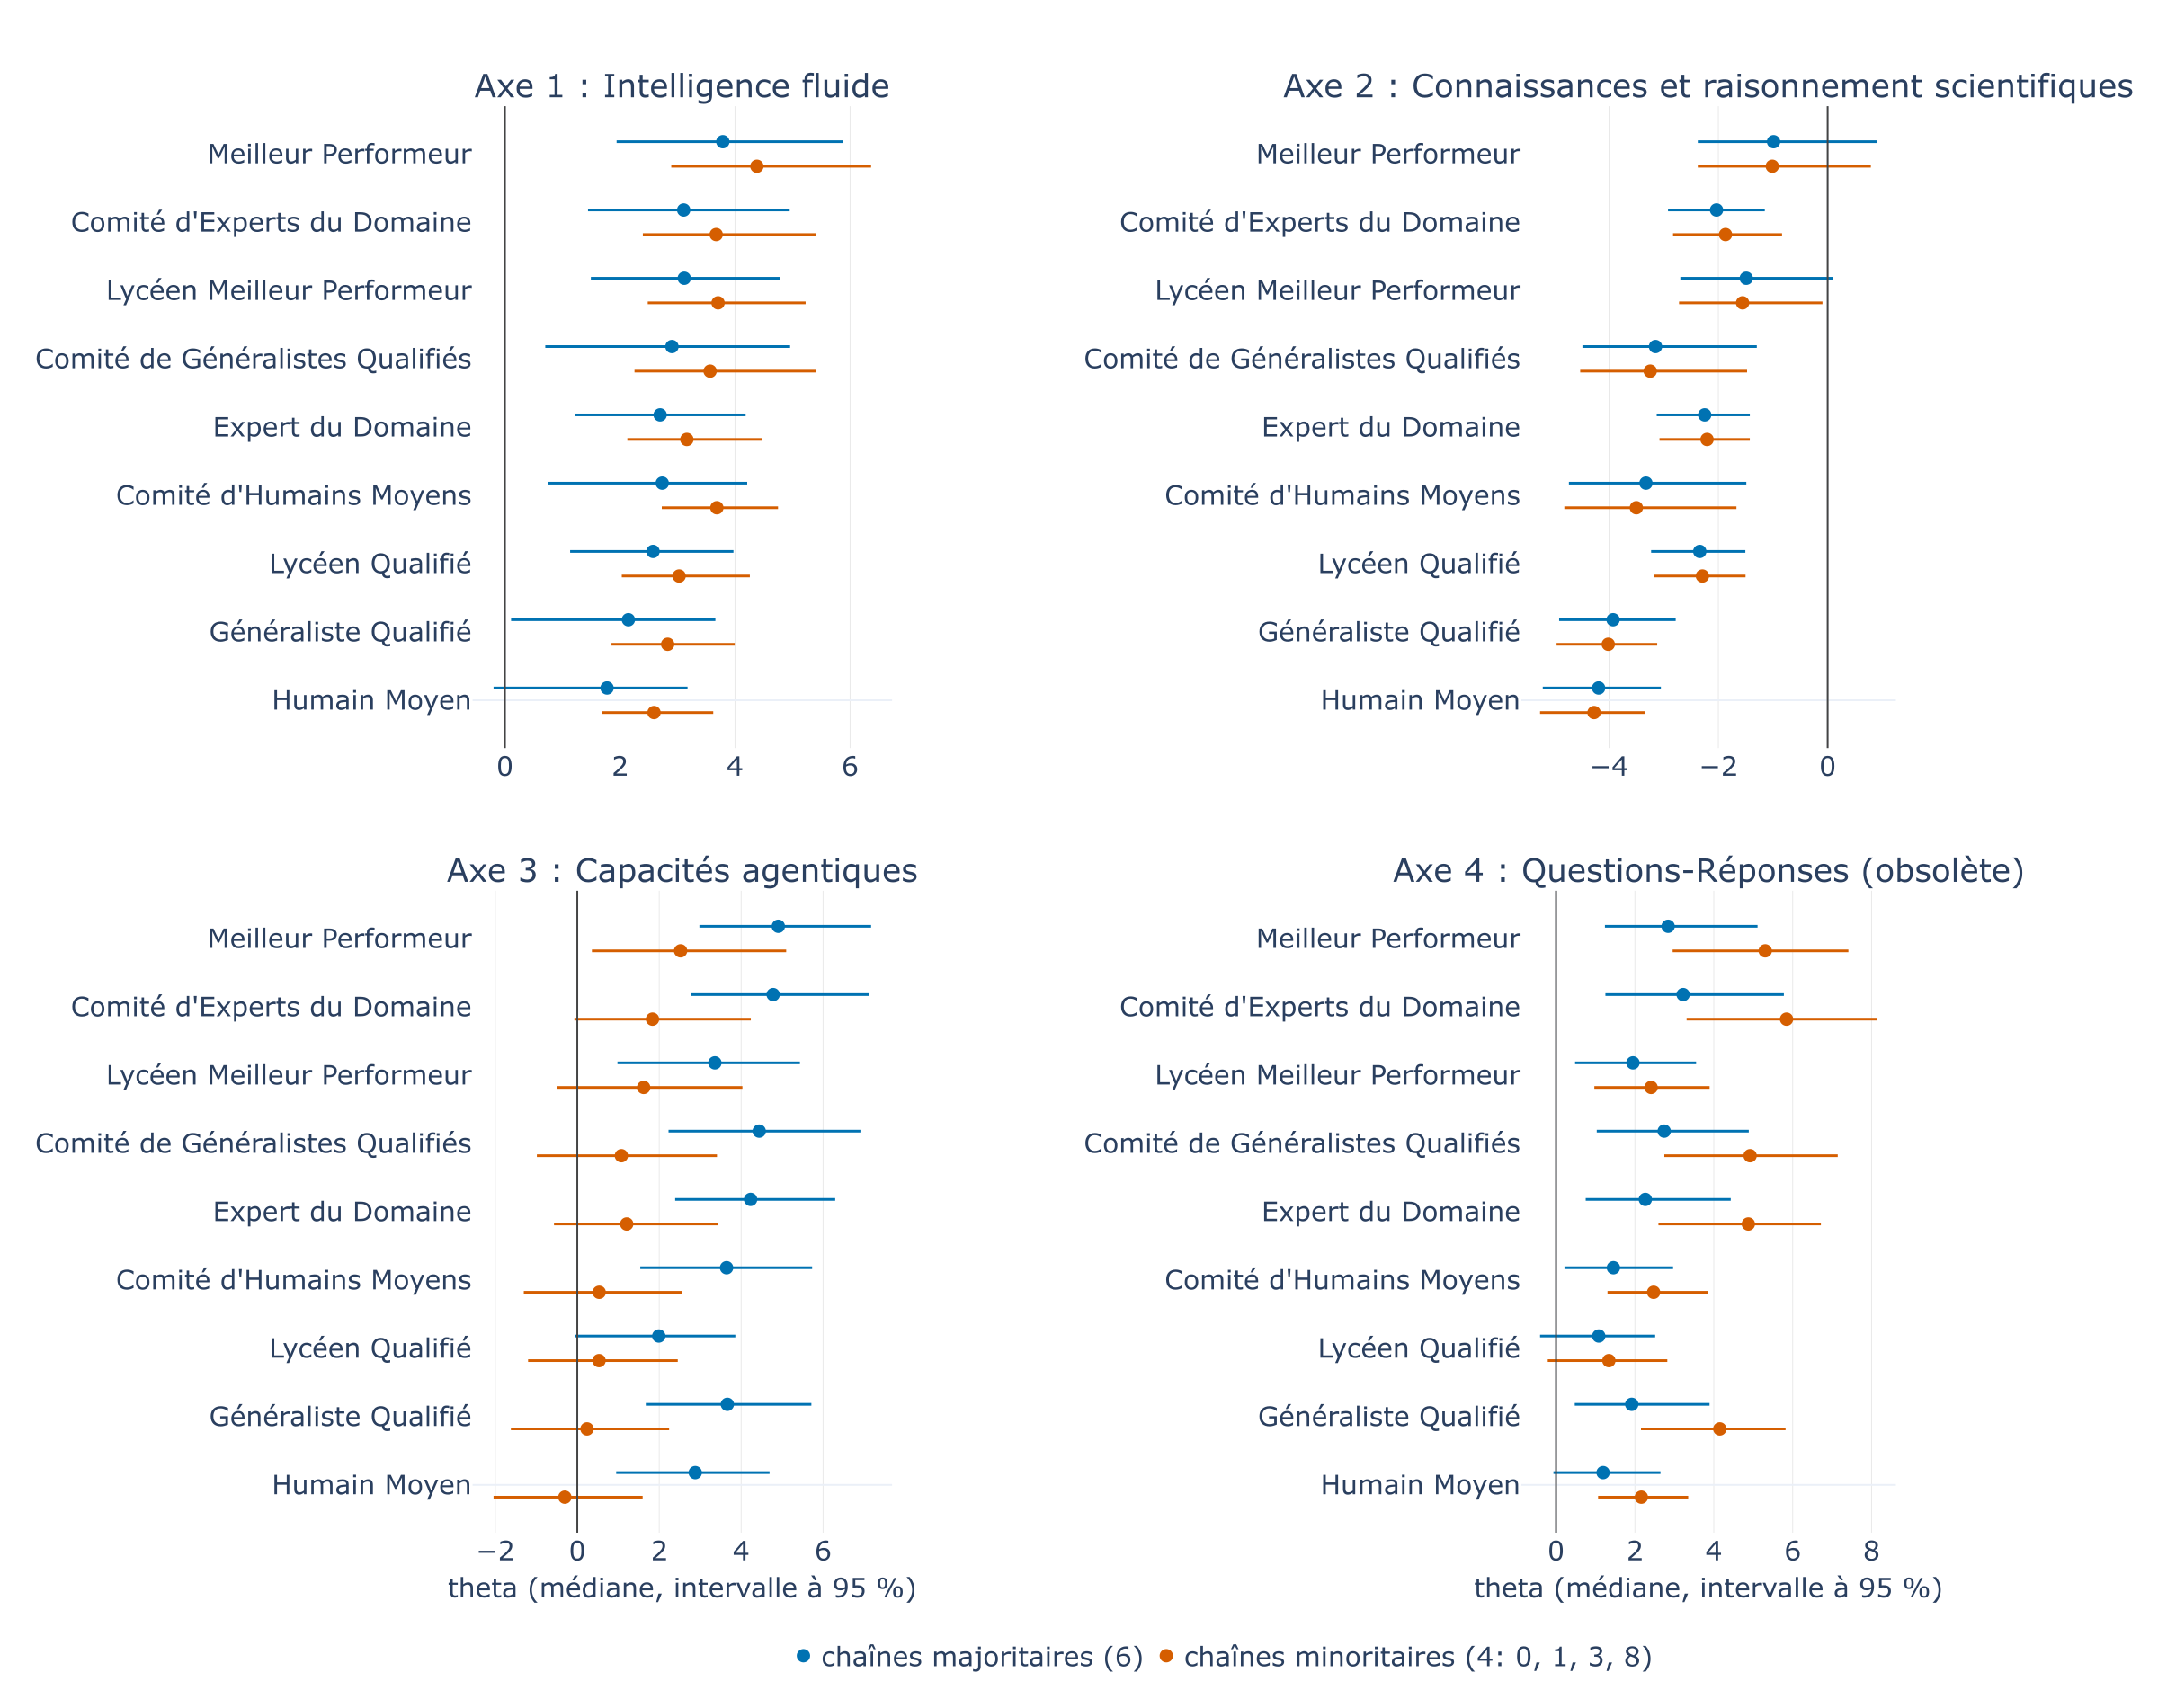
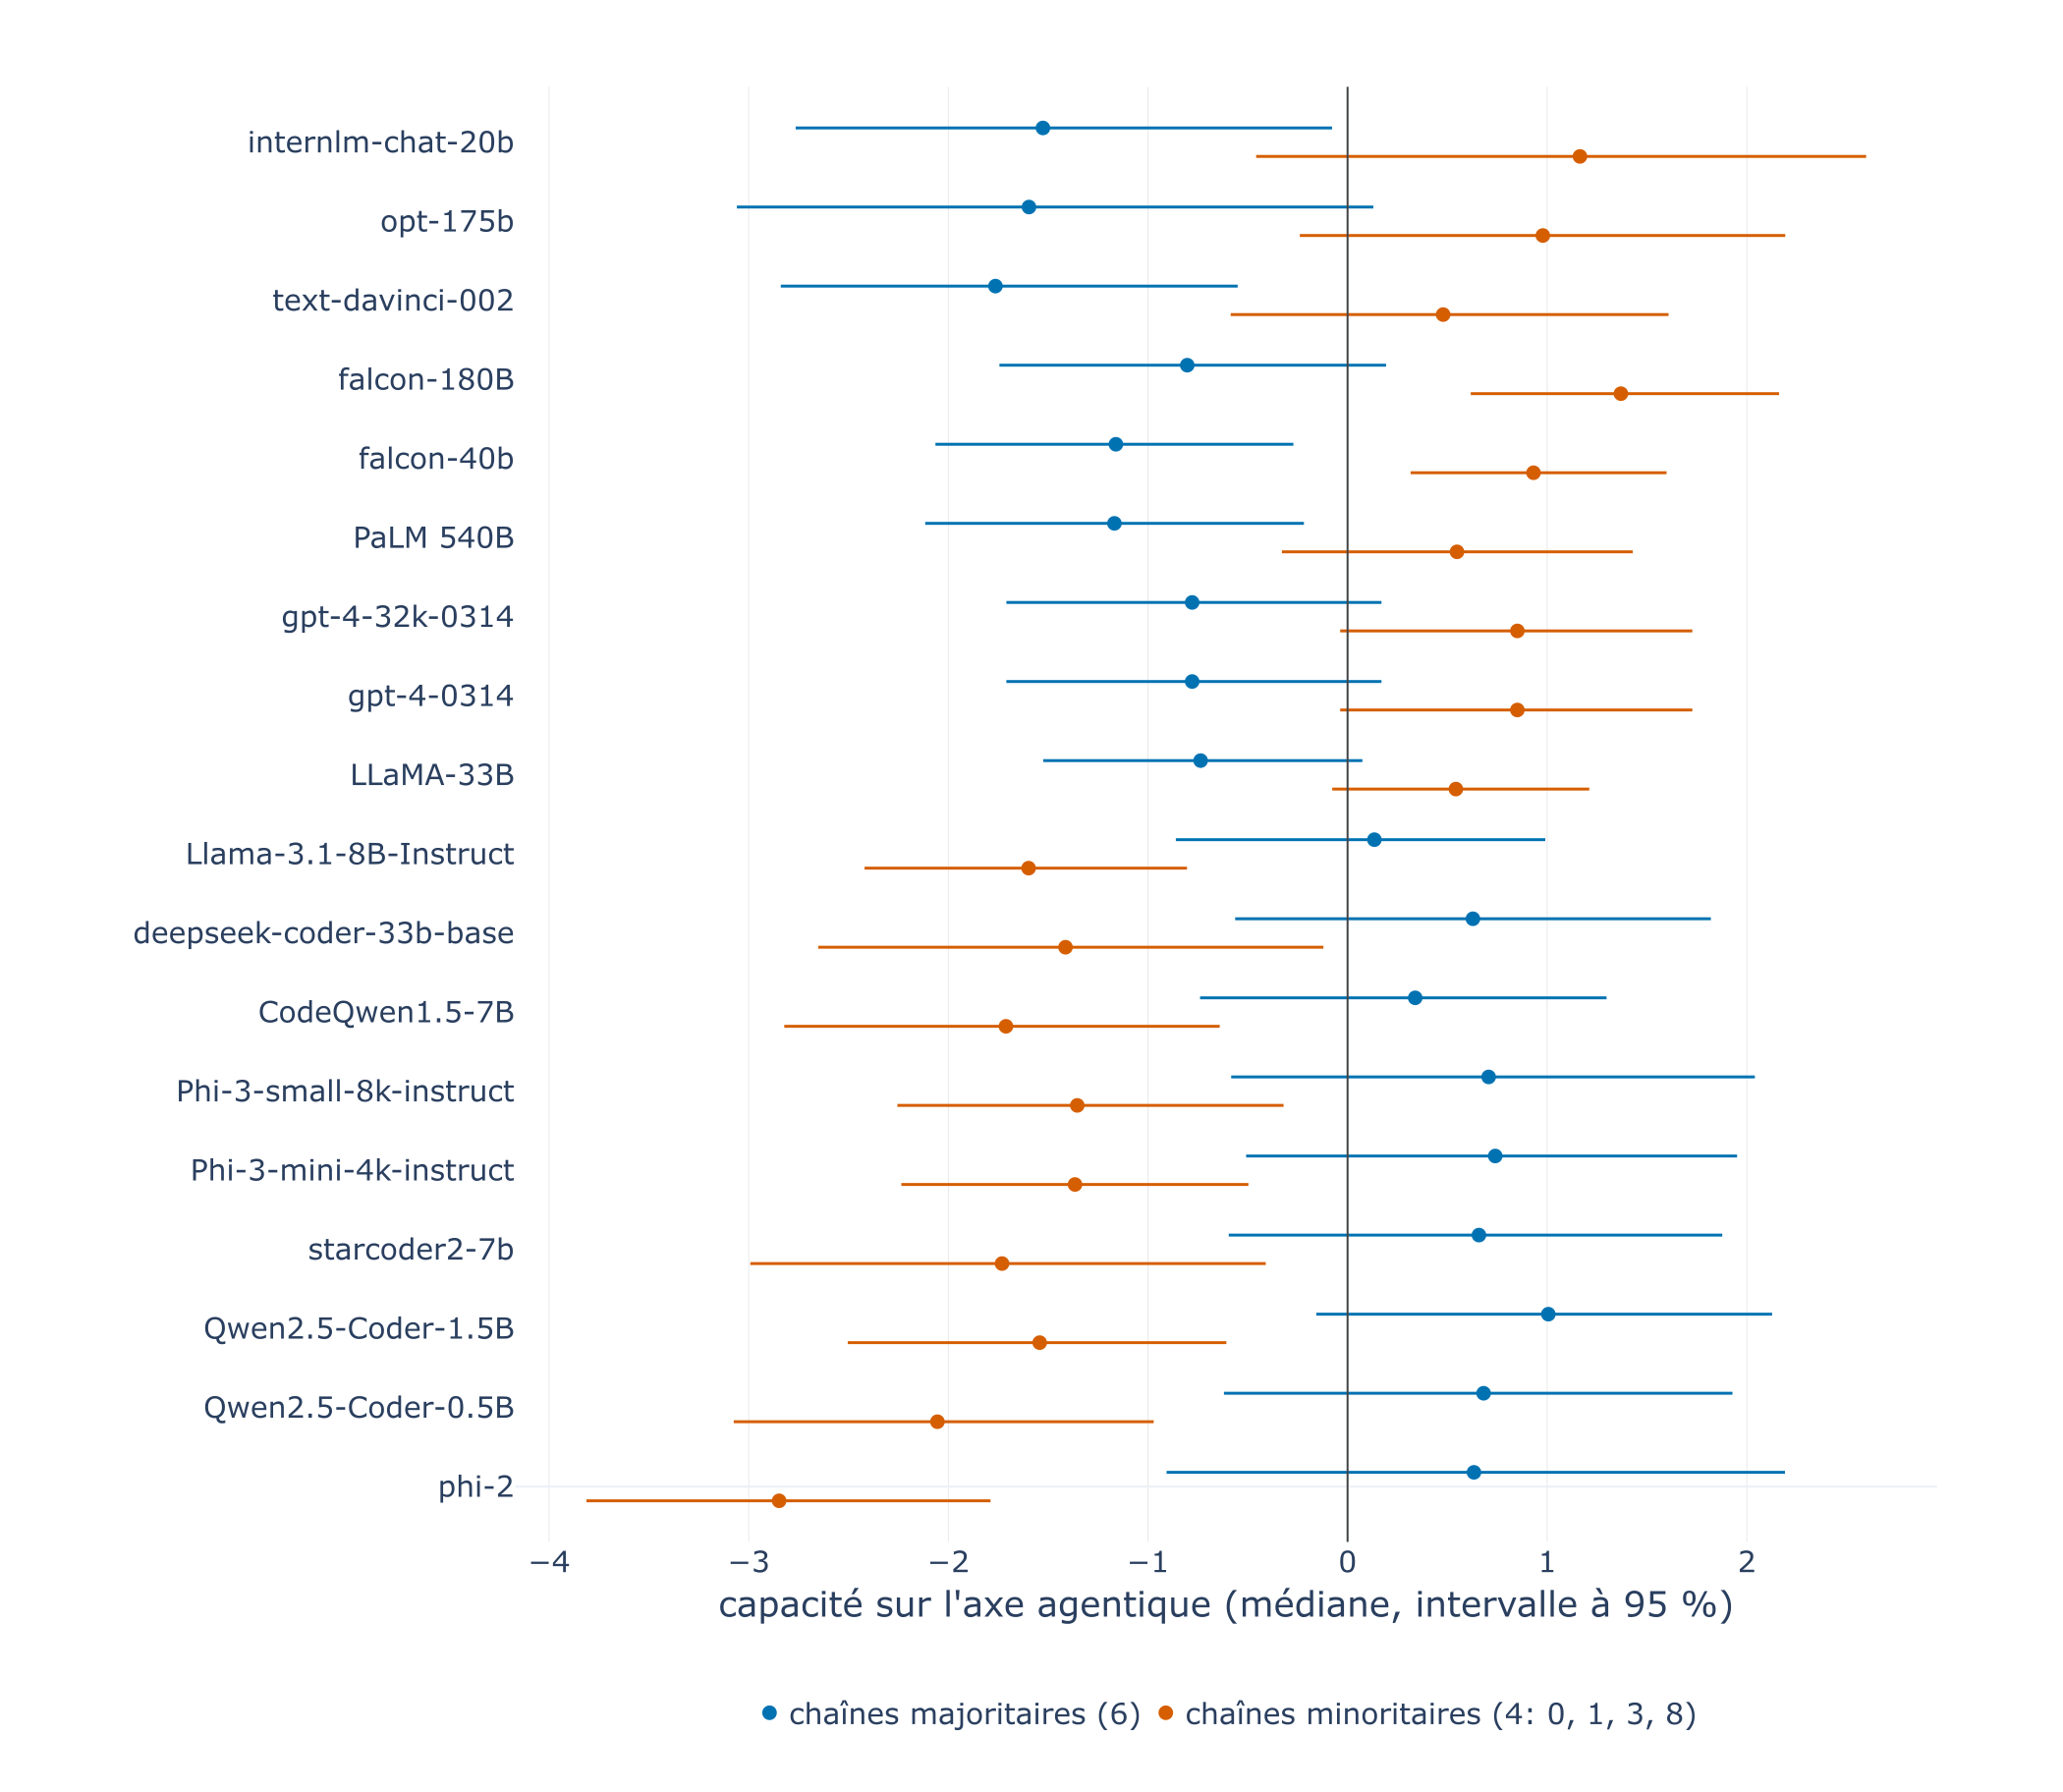
Voici les projections pour les chaînes minoritaires.
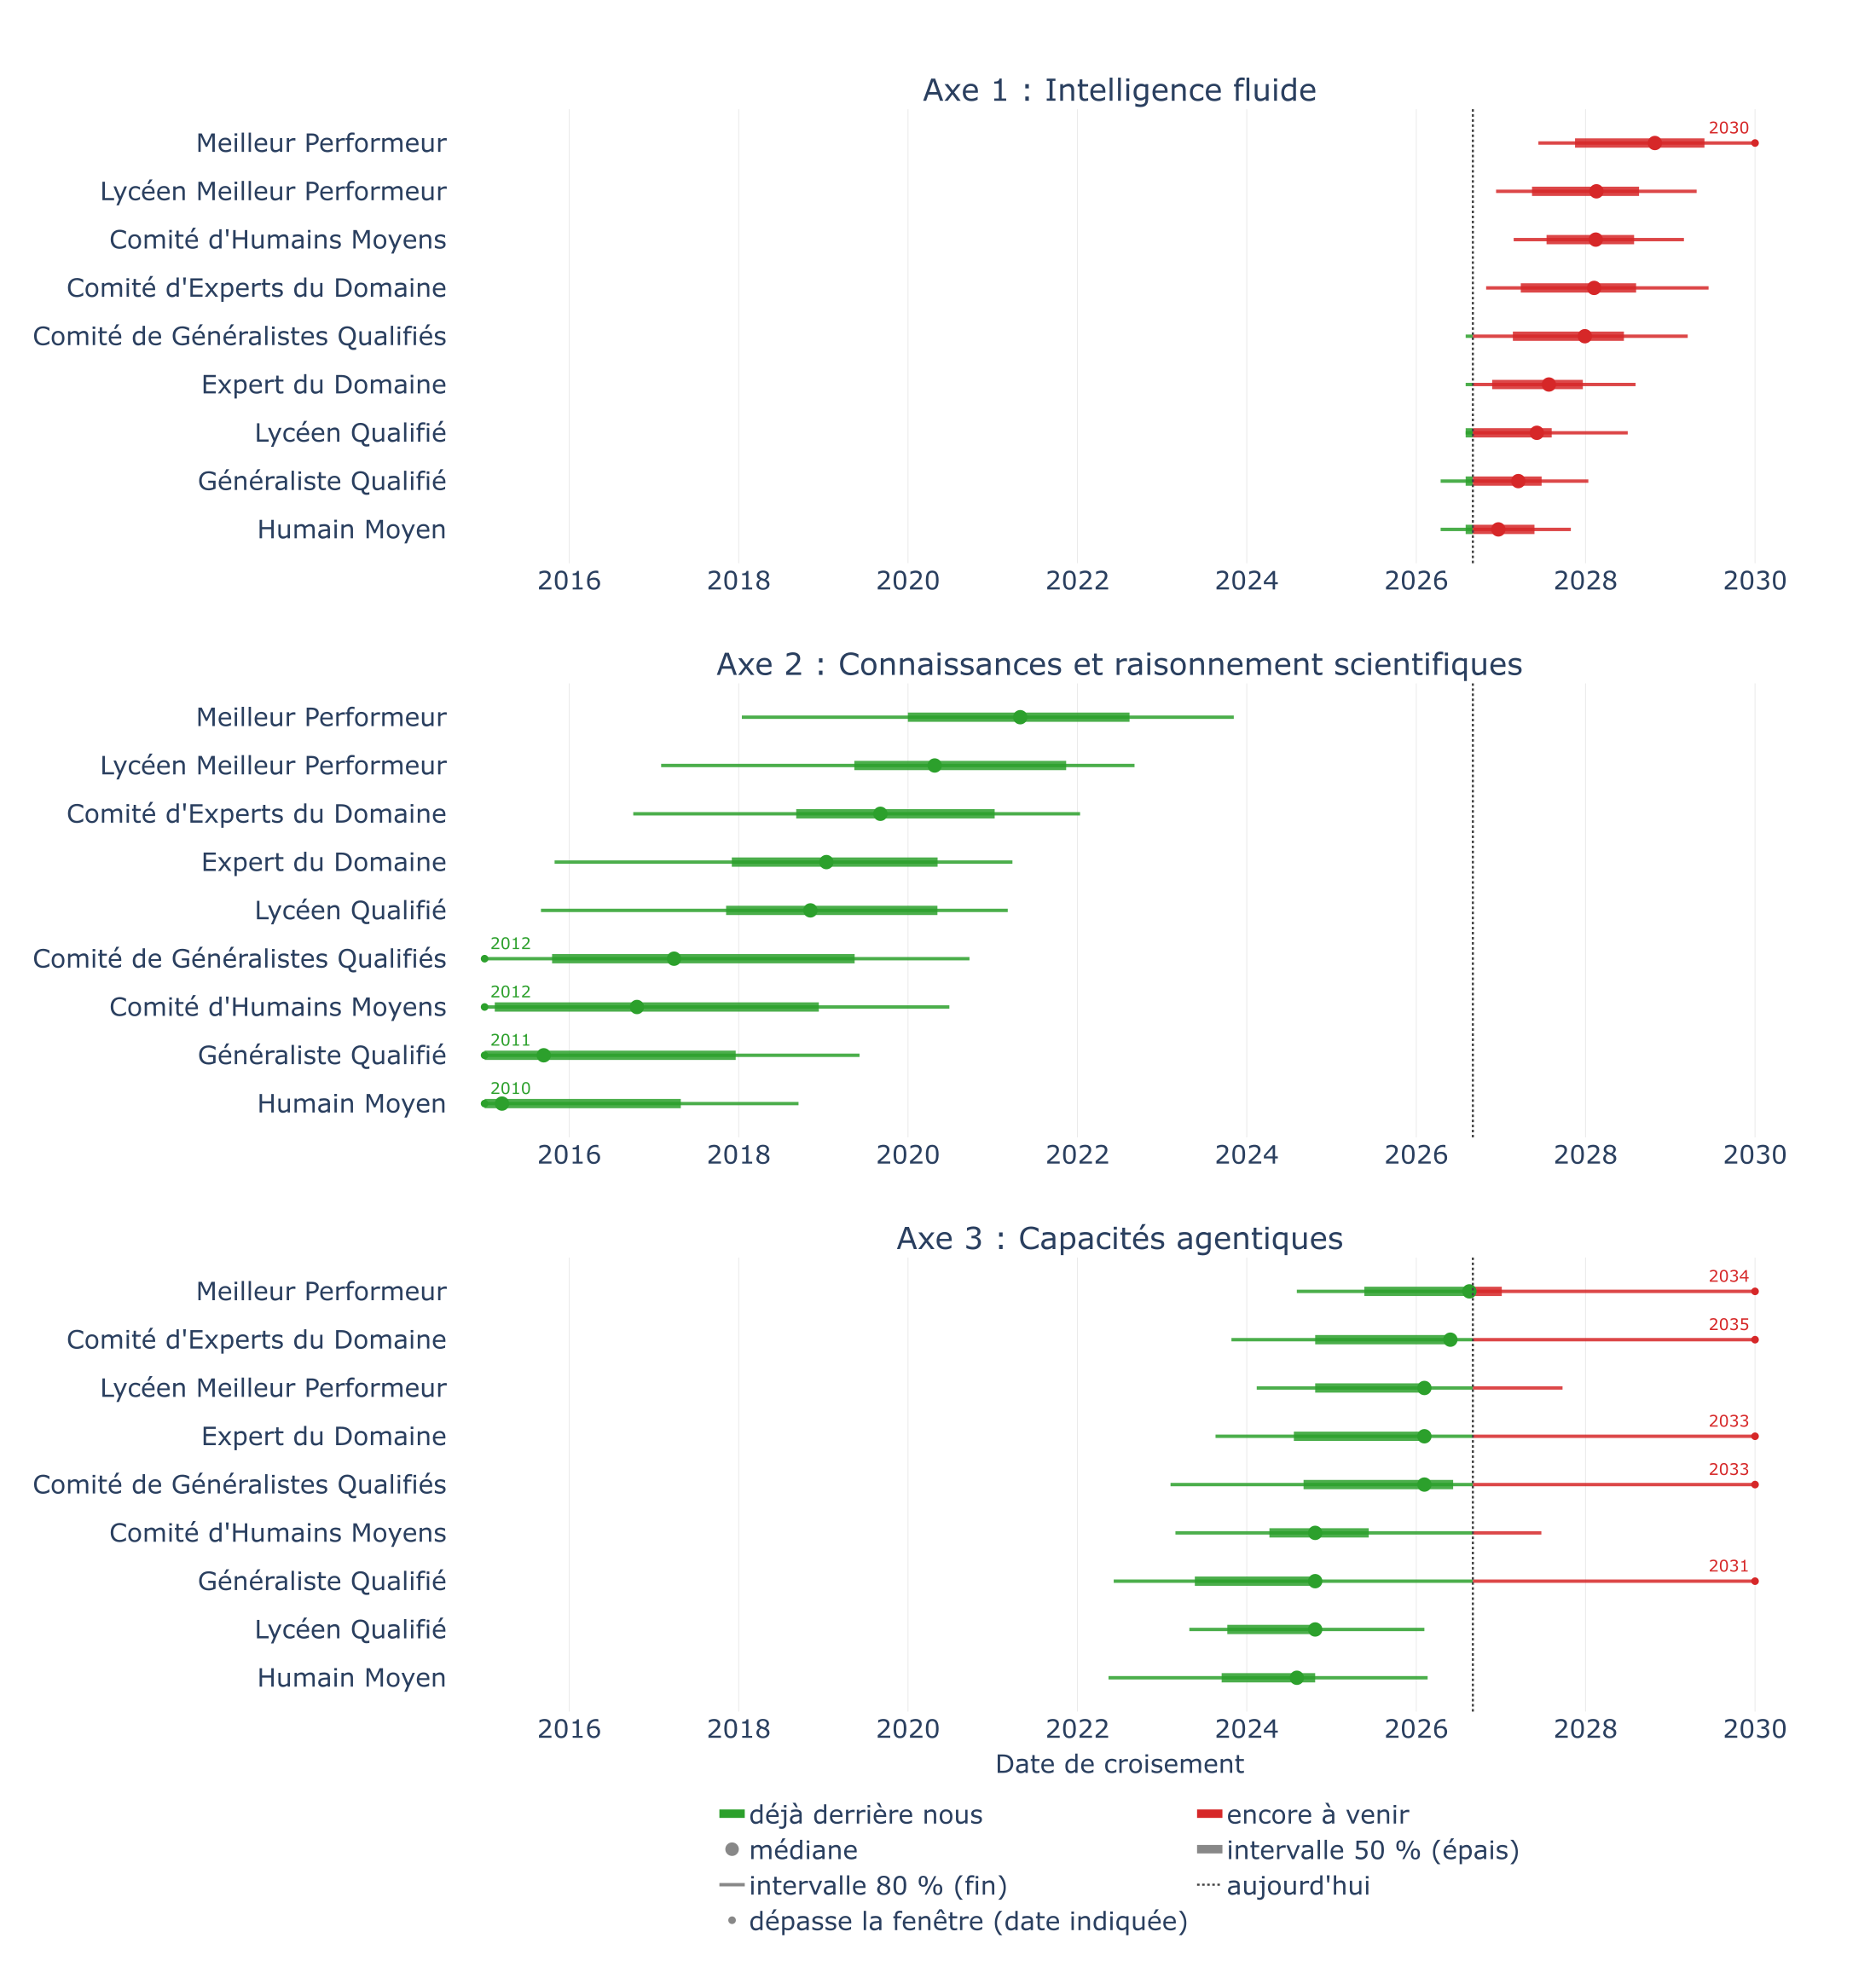
Dans les prévisions minoritaires, tous les niveaux humains seront bientôt dépassés sur l’axe Capacités Agentiques, et les IA de frontière restent au contraire sous l’Humain Moyen sur l’Intelligence Fluide, contrairement à ce que prédisent les chaînes majoritaires.
Annexe D - Les intervalles à 95 %
Voici les dates de croisement avec les intervalles à 95 %, pour les chaînes majoritaires et minoritaires.
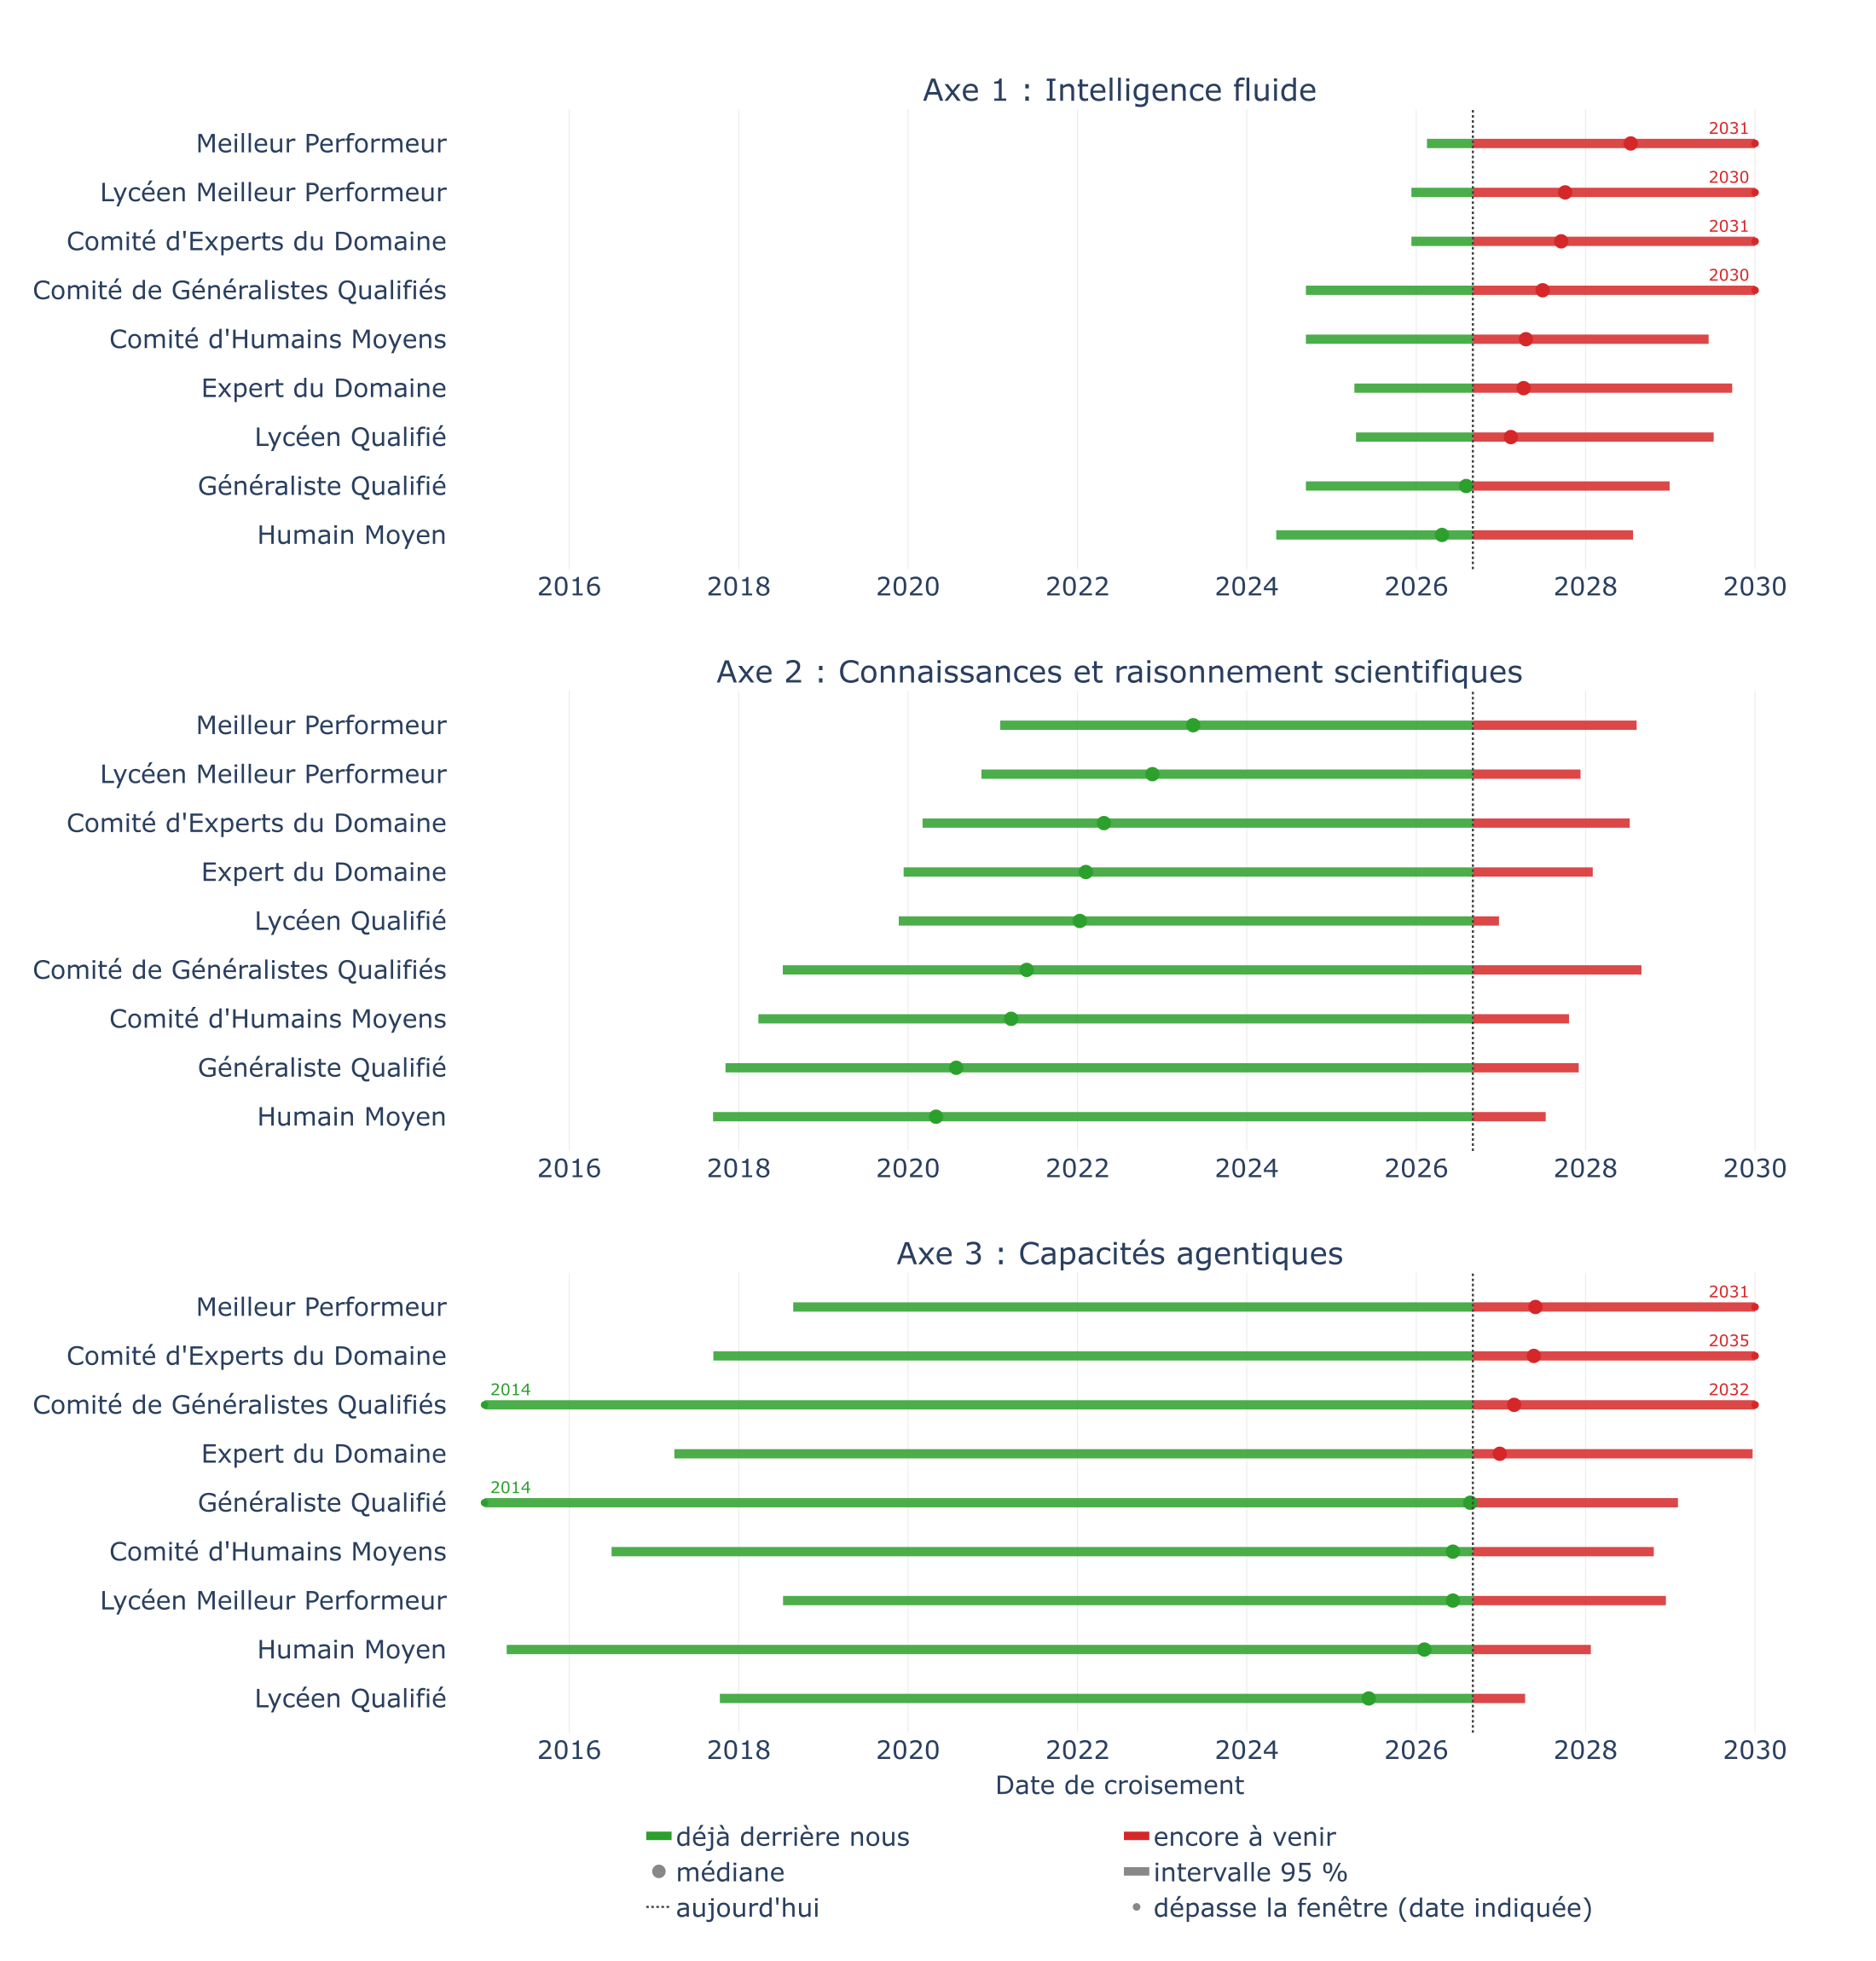
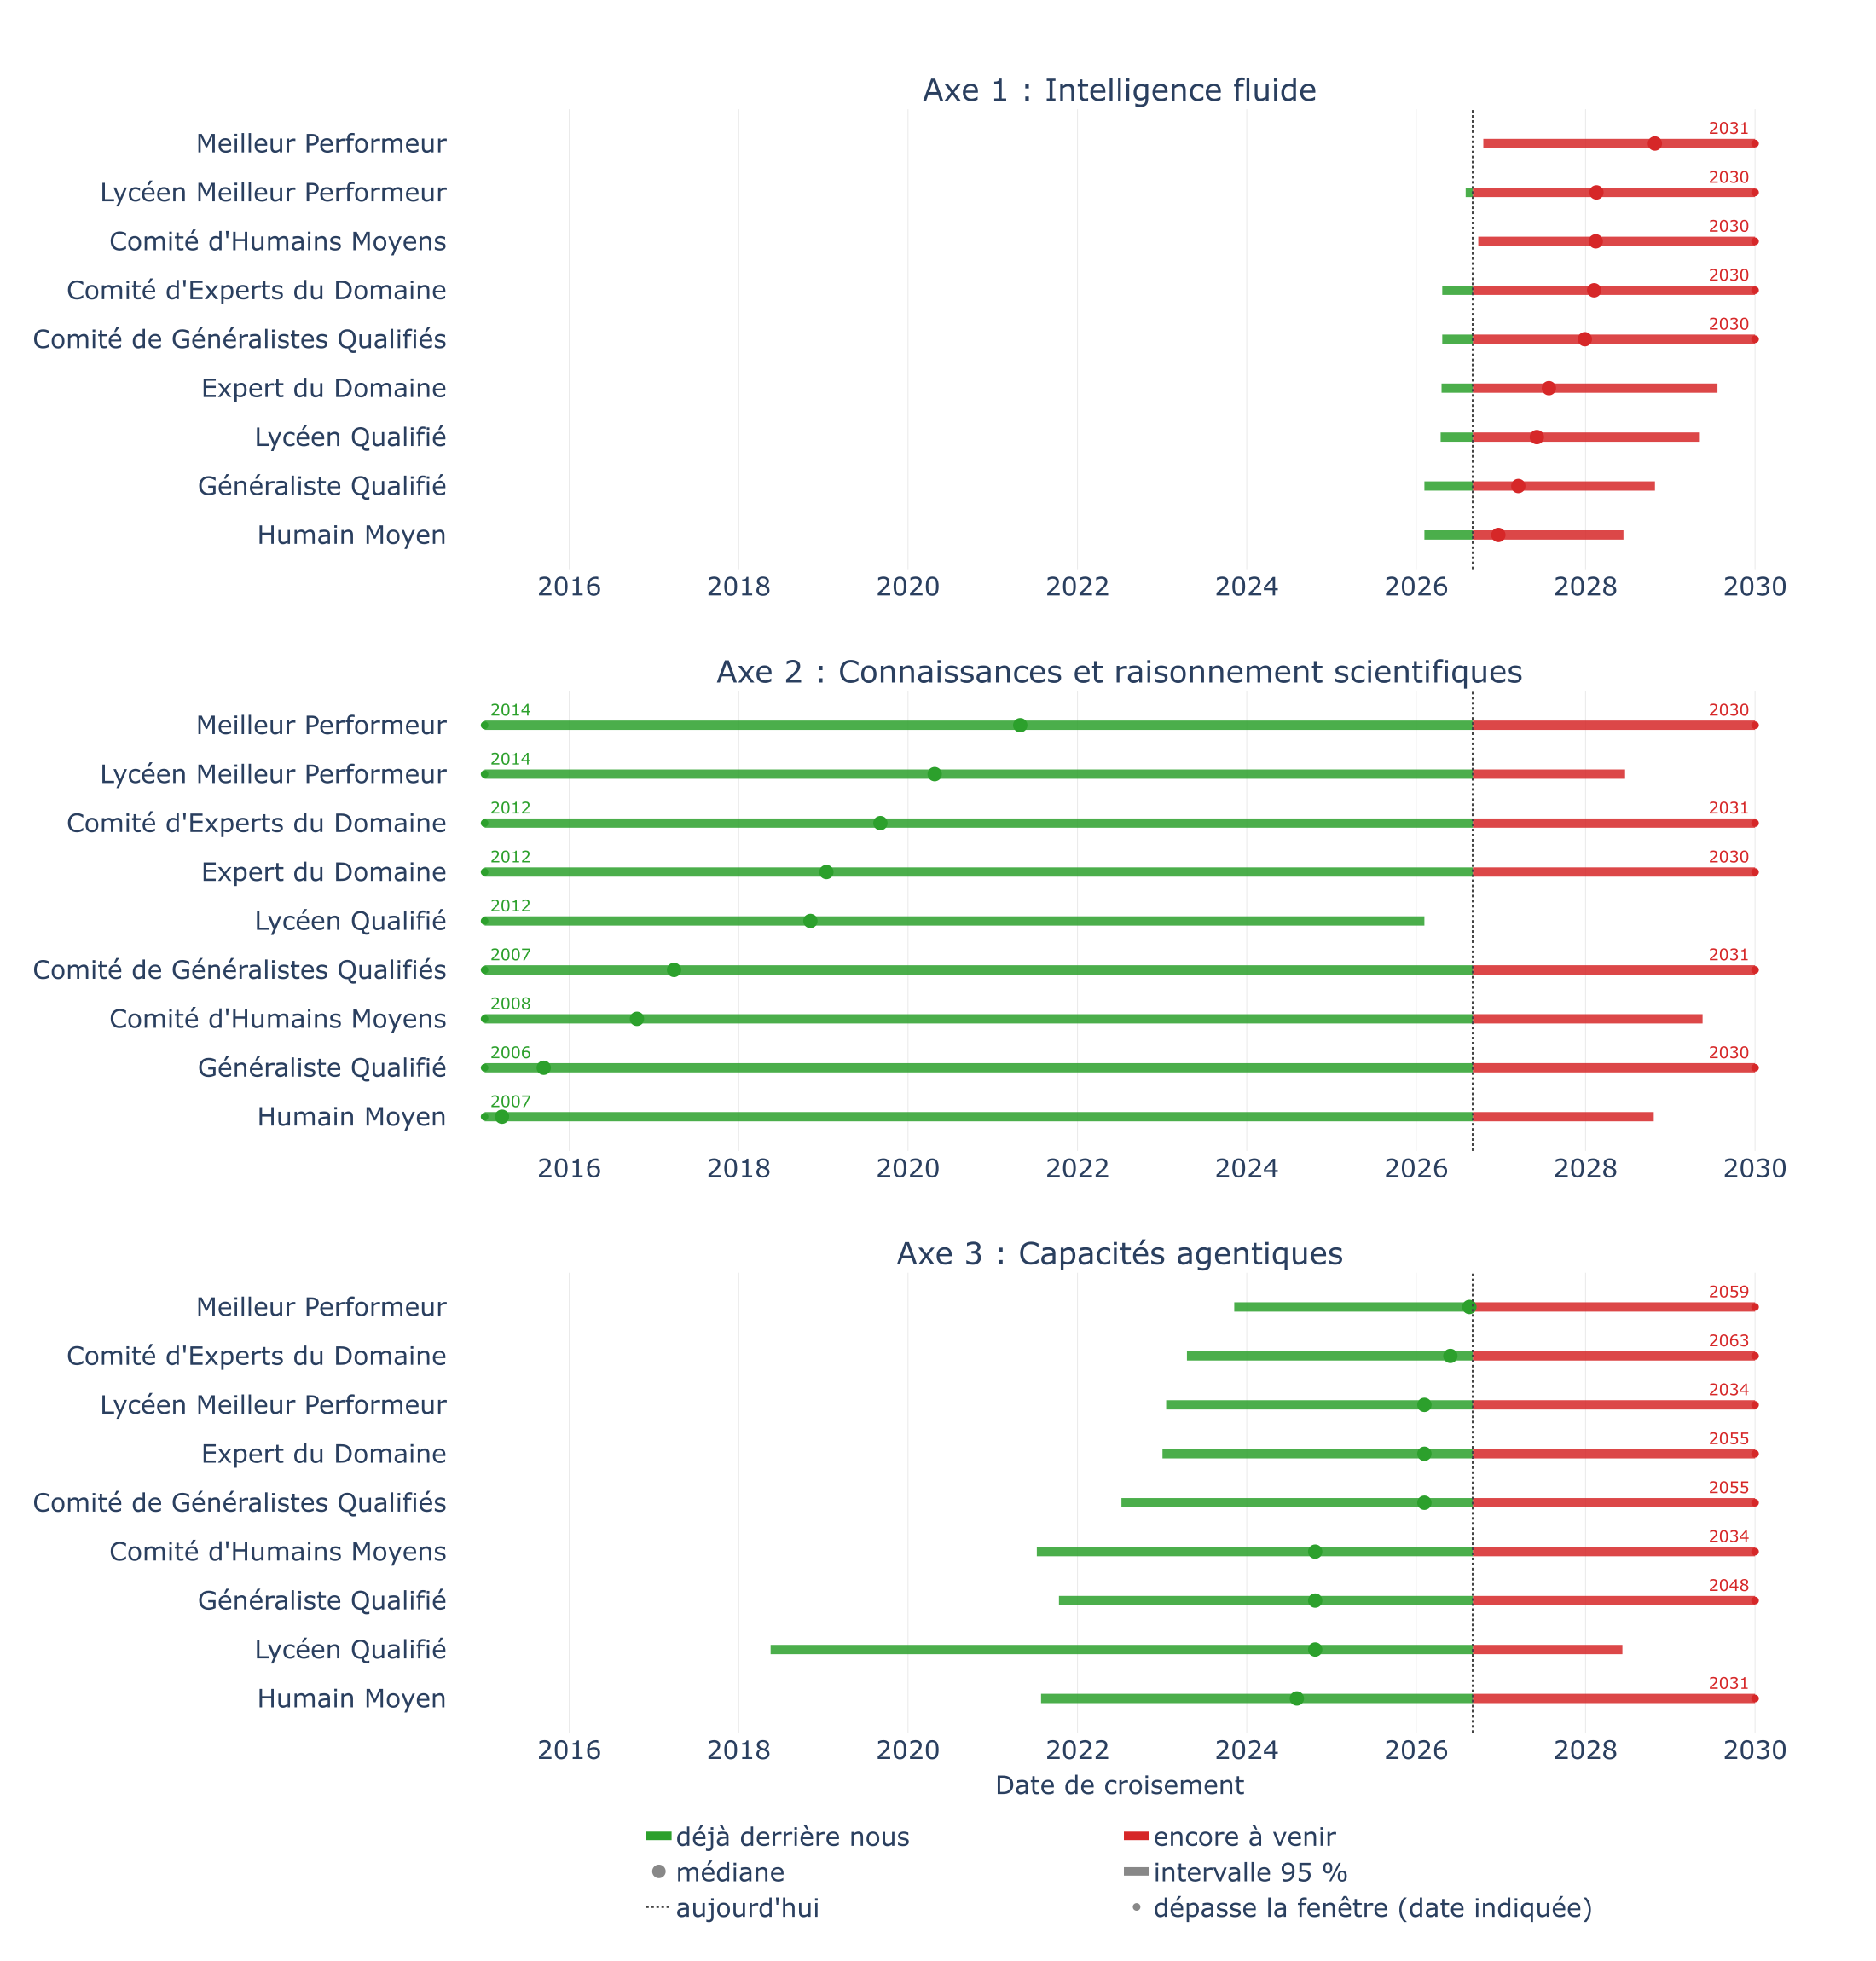
Pour les chaînes majoritaires, les fenêtres à 95 % sont nettement plus larges sur tous les axes, mais se referment au plus tard en 2035. Pour les chaînes minoritaires, seul l’axe Intelligence Fluide garde des intervalles à 95 % relativement resserrés ; partout ailleurs, les incertitudes deviennent très importantes.
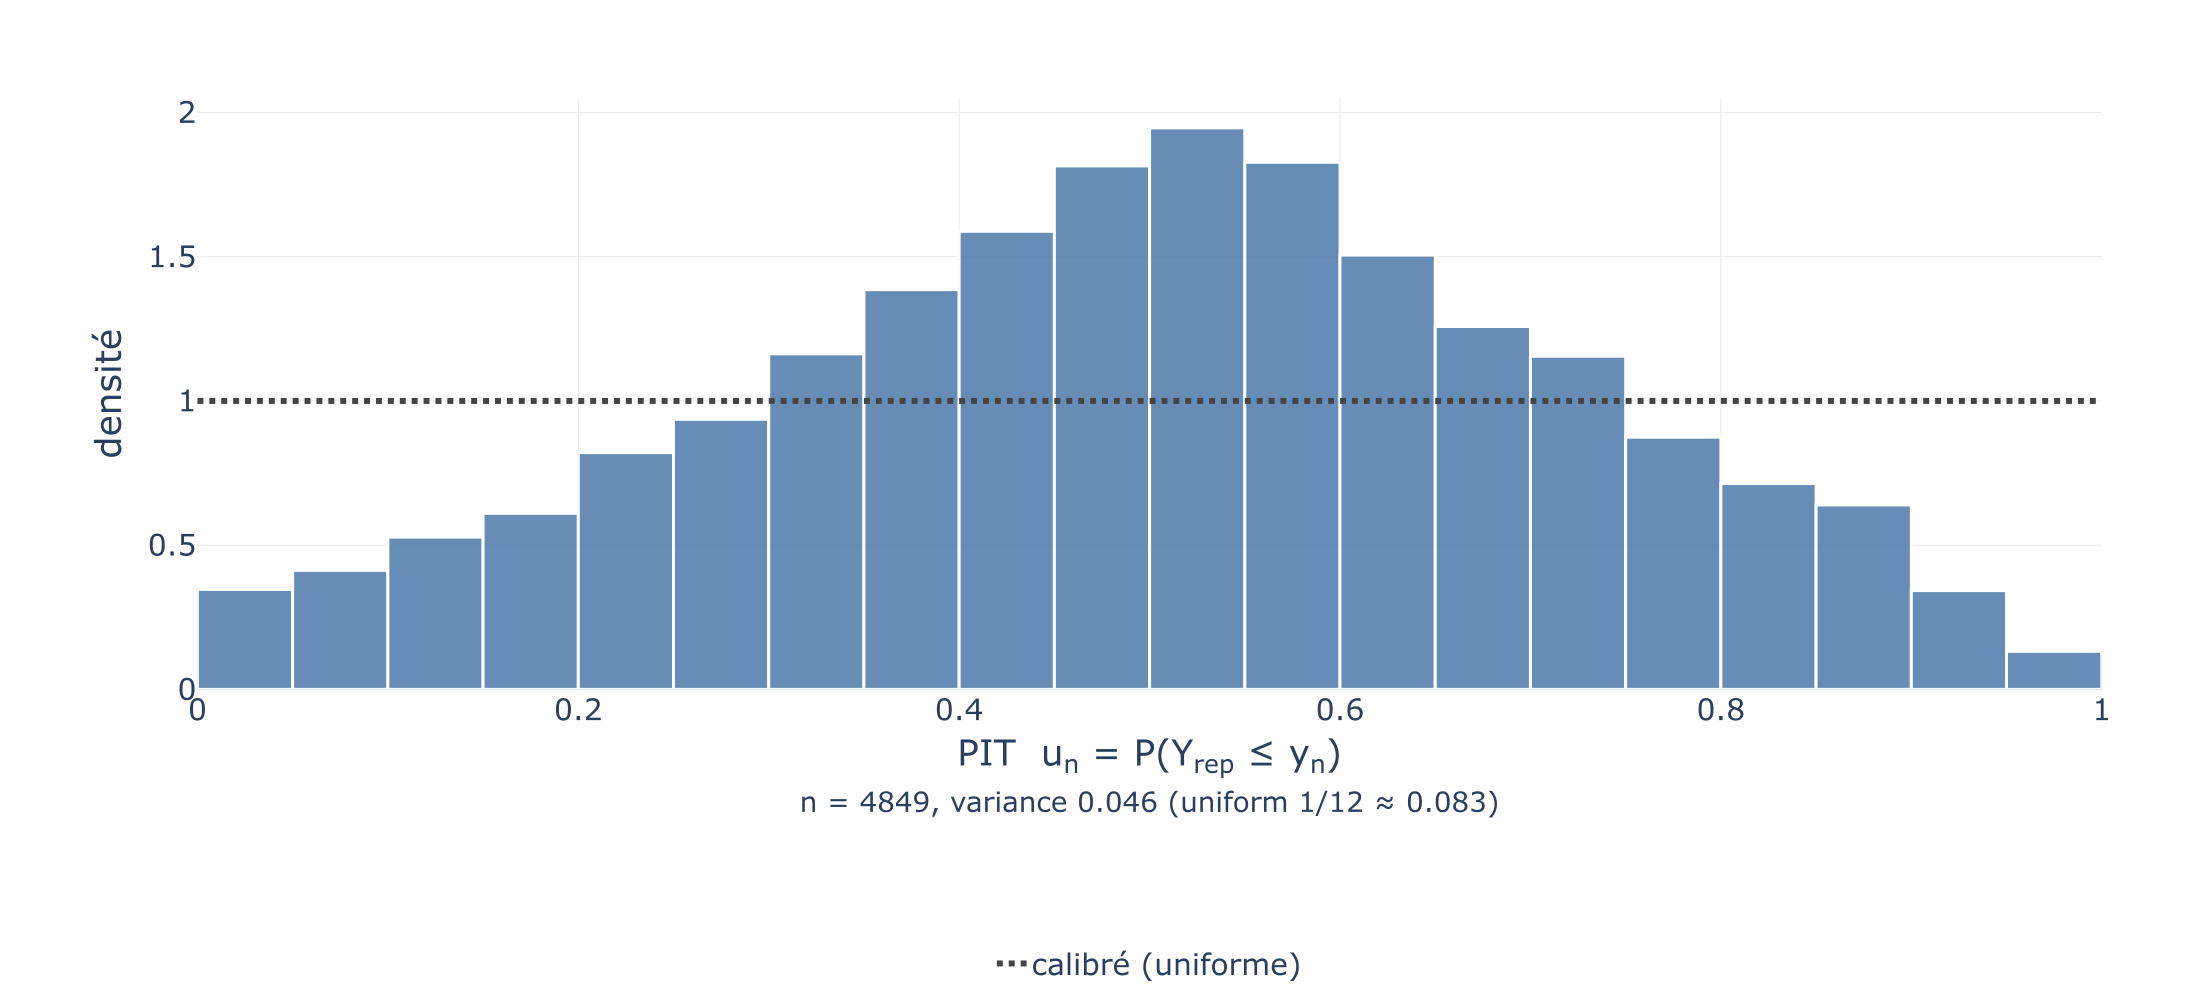
Annexe E - Calibration (PIT)
Pour chaque score observé, nous calculons où il tombe dans la distribution prédictive du modèle mathématique (la transformation intégrale de probabilité, PIT). Un modèle parfaitement calibré répartirait ces valeurs uniformément. Notre histogramme bombe au centre, les scores observés tombant près du centre des intervalles prédictifs plus souvent qu’ils ne le devraient. Les intervalles sont donc plus larges que nécessaire, et les résultats inutilement conservateurs.
Annexe F - Références humaines et liste des benchmarks
Les références humaines
| Benchmark | Niveau humain | Score | Source | Précisions |
|---|---|---|---|---|
| ARC-AGI | Humain Moyen | 0,77 | ARC Prize | MTurk |
| ARC-AGI-2 | Humain Moyen | 0,6 | ARC Prize | Participant moyen |
| BIG-Bench Hard (BBH) | Humain Moyen | 0,677 | BIG-Bench Hard | Évaluateurs humains, moyenne |
| BoolQ | Humain Moyen | 0,9 | BoolQ | Annotateurs humains |
| CSQA2 | Humain Moyen | 0,903 | CSQA2 | Précision moyenne des humains |
| MMLU | Humain Moyen | 0,345 | MMLU | MTurk |
| OpenBookQA | Humain Moyen | 0,92 | OpenBookQA | Probabilité estimée sur des sujets humains tirés au hasard |
| ScienceQA | Humain Moyen | 0,884 | ScienceQA | Travailleurs MTurk titulaires au moins du baccalauréat, ayant réussi les exemples de qualification |
| SimpleBench | Humain Moyen | 0,837 | SimpleBench | Neuf humains non spécialisés |
| SuperGLUE | Humain Moyen | 0,898 | SuperGLUE | Estimation de la performance humaine après phase d’entraînement |
| TriviaQA | Humain Moyen | 0,797 | TriviaQA | Niveau de performance humaine |
| VPCT | Humain Moyen | 0,999 | Epoch AI | Trois volontaires |
| ARC-AGI | Comité d’Humains Moyens | 0,98 | ARC Prize | Panel humain (au moins deux participants ont résolu une ou plusieurs sous-paires en deux essais) |
| ARC-AGI-2 | Comité d’Humains Moyens | 0,999 | ARC Prize | Panel humain |
| CSQA2 | Comité d’Humains Moyens | 0,941 | CSQA2 | Vote majoritaire |
| HellaSwag | Comité d’Humains Moyens | 0,956 | HellaSwag | Vote majoritaire de 5 annotateurs (MTurk) |
| WinoGrande | Comité d’Humains Moyens | 0,94 | WinoGrande | Vote majoritaire d’annotateurs (MTurk) |
| ARC-AGI | Généraliste Qualifié | 0,98 | ARC Prize | Diplômés STEM |
| GPQA Diamond | Généraliste Qualifié | 0,219 | GPQA Diamond | Non-spécialistes très qualifiés et incités, docteurs ou doctorants dans d’autres domaines |
| GPQA Diamond Biology | Généraliste Qualifié | 0,22 | GPQA Diamond Biology | Docteur hors domaine |
| GPQA Diamond Chemistry | Généraliste Qualifié | 0,22 | GPQA Diamond Chemistry | Docteur hors domaine |
| GPQA Main Biology | Généraliste Qualifié | 0,43 | GPQA Main Biology | Docteur hors domaine |
| GPQA Main Chemistry | Généraliste Qualifié | 0,31 | GPQA Main Chemistry | Docteur hors domaine |
| GSM8K | Généraliste Qualifié | 0,9677 | GSM8K | Annotateurs qualifiés ayant réussi un examen de qualification, avec au moins une licence |
| MATH Level 5 | Généraliste Qualifié | 0,4 | MATH Level 5 | Un doctorant en informatique qui n’aime pas particulièrement les mathématiques |
| OS World (Screenshot) | Généraliste Qualifié | 0,724 | OS World | Personnes non familières du logiciel |
| SimpleQA Verified | Généraliste Qualifié | 0,944 | SimpleQA Verified | Annotateur humain passant le test |
| Visual Task Assessment (VISTA) | Généraliste Qualifié | 0,554 | Scale SEAL | 16 employés à temps plein |
| PIQA | Comité de Généralistes Qualifiés | 0,949 | PIQA | Vote majoritaire des meilleurs annotateurs |
| OTIS Mock AIME 2024-2025 | Lycéen Qualifié | 0,53 | OTIS Mock AIME | Score moyen des lycéens du programme OTIS (pourcentage rapporté au nombre de questions traitées) |
| OTIS Mock AIME 2024-2025 | Lycéen Meilleur Performeur | 0,93 | OTIS Mock AIME | Meilleur score du programme OTIS (pourcentage rapporté au nombre de questions traitées) |
| BioLP-bench | Expert du Domaine | 0,384 | Rapport RAND | Licence avec expérience en laboratoire |
| GPQA Diamond | Expert du Domaine | 0,812 | GPQA Diamond | Docteurs validateurs du domaine, article GPQA, table 2 |
| GPQA Diamond Biology | Expert du Domaine | 0,831 | Rapport RAND | Docteur du domaine |
| GPQA Diamond Chemistry | Expert du Domaine | 0,831 | Rapport RAND | Docteur du domaine |
| GPQA Main Biology | Expert du Domaine | 0,667 | Rapport RAND | Docteur du domaine |
| GPQA Main Chemistry | Expert du Domaine | 0,72 | Rapport RAND | Docteur du domaine |
| LAB-Bench Cloning | Expert du Domaine | 0,6 | Rapport RAND | Docteur du domaine |
| LAB-Bench LitQA2 | Expert du Domaine | 0,7 | Rapport RAND | Docteur du domaine |
| LAB-Bench Protocol | Expert du Domaine | 0,79 | Rapport RAND | Docteur du domaine |
| LAB-Bench SeqQA | Expert du Domaine | 0,78 | Rapport RAND | Docteur du domaine |
| MATH Level 5 | Expert du Domaine | 0,9 | MATH Level 5 | Un étudiant trois fois médaillé d’or aux Olympiades internationales de mathématiques |
| WMDP Biology | Expert du Domaine | 0,605 | Rapport RAND | Docteur du domaine (RAND) |
| WMDP Chemistry | Expert du Domaine | 0,433 | Rapport RAND | Docteur du domaine (RAND) |
| MMLU | Lycéen Meilleur Performeur | 0,898 | MMLU | Estimation des auteurs à partir du 95e percentile des résultats des élèves |
| MMLU Biology | Lycéen Meilleur Performeur | 0,9 | Rapport RAND | Idem |
| MMLU Chemistry | Lycéen Meilleur Performeur | 0,9 | Rapport RAND | Idem |
| FrontierMath | Comité d’Experts du Domaine | 0,35 | Epoch AI | Résolu collectivement par l’ensemble des équipes (40 étudiants exceptionnels en mathématiques et spécialistes du domaine) en quatre heures et demie, avec accès à internet |
| PRBench Finance | Comité d’Experts du Domaine | 0,796 | PRBench Finance | Accord entre experts humains |
| PRBench Legal | Comité d’Experts du Domaine | 0,796 | PRBench Legal | Accord entre experts humains |
| BIG-Bench Hard (BBH) | Meilleur Performeur | 0,944 | BIG-Bench Hard | Meilleur évaluateur humain |
| GeoBench | Meilleur Performeur | 0,9 | GeoBench | Meilleur joueur |
La liste des benchmarks
Les 97 benchmarks inclus dans le modèle.
- APEX Agents
- ARC (AI2)
- ARC-AGI
- ARC-AGI-2
- Adversarial NLI
- Aider Polyglot
- AudioMultiChallenge
- BALROG
- BIG-Bench Hard (BBH)
- BioLP-bench
- BlueprintBench 2
- BoolQ
- CAD-Eval
- CL-Bench
- CL-Bench Life
- CSQA2
- Chess Puzzles
- CritPt
- CursorBench
- Cybench
- DeepResearchBench
- DeepSWE
- EBR-bench
- EnigmaEval
- ExploitBench
- Fiction.LiveBench
- ForecastBench
- FrontierCode
- FrontierMath
- FrontierMath Tier 4
- GBAEval
- GDP.pdf
- GDPval
- GPQA Diamond
- GPQA Diamond Biology
- GPQA Diamond Chemistry
- GPQA Main Biology
- GPQA Main Chemistry
- GSM8K
- GSO-Bench
- GeoBench
- HellaSwag
- Humanity’s Last Exam
- LAB-Bench Cloning
- LAB-Bench LitQA2
- LAB-Bench Protocol
- LAB-Bench SeqQA
- LAMBADA
- Lech Mazur Writing
- LiveBench
- MATH Level 5
- MCP Atlas
- METR Time Horizons
- MMLU
- MMLU Biology
- MMLU Chemistry
- MMLU Pro Biology
- MMLU Pro Chemistry
- MMLU-Pro
- MindCube
- MultiChallenge
- MultiNRC
- Mystery Game Puzzles
- OS World (Screenshot)
- OS World 2
- OTIS Mock AIME 2024-2025
- OpenBookQA
- PIQA
- PRBench Finance
- PRBench Legal
- PostTrainBench
- ProofBench
- Remote Labor Index
- SEAL Instruction Following
- SEAL Tool Use (Enterprise)
- SWE-Bench Pro
- SWE-Bench Pro (Private)
- SWE-Bench Verified
- SciCode
- ScienceQA
- SimpleBench
- SimpleQA Verified
- SpatialViz-Bench
- SuperGLUE
- Surface Evolver Bench
- TerminalBench
- The Agent Company
- TriviaQA
- TutorBench
- VPCT
- Video-MME
- Visual Task Assessment (VISTA)
- VisualToolBench
- WMDP Biology
- WMDP Chemistry
- WeirdML
- WinoGrande
Les benchmarks exclus de l’ajustement unidimensionnel
- ARC-AGI
- ARC-AGI-2
- HellaSwag
- OpenBookQA
- PIQA
- SimpleBench
- VPCT
- WinoGrande
Code
Le code et les données de nos analyses sont disponibles sur github.com/General-Purpose-AI-Policy-Lab/Multiaxis_ECI.
Citer ce billet
GPAI Policy Lab. « Les progrès de l’IA face aux experts humains : intelligence fluide, connaissances et raisonnements scientifiques, capacités agentiques. » Septembre 2026. https://gpaipolicylab.org/blog-5.